RAG Explained: How Retrieval-Augmented Generation Helps AI Give Better Answers
Introduction
ಒಂದು AI chatbotಗೆ ನೀವು ಒಂದು ಪ್ರಶ್ನೆ ಕೇಳುತ್ತೀರಿ. ಅದು ಬಹಳ confident ಆಗಿ answer ಕೊಡುತ್ತದೆ. ಆದರೆ ಆ answer ನಿಮ್ಮ company documentsನಲ್ಲಿ ಇಲ್ಲದ information ಆಗಿರಬಹುದು, outdated ಆಗಿರಬಹುದು ಅಥವಾ completely incorrect ಆಗಿರಬಹುದು.
ಇಲ್ಲಿಯೇ RAG AI ಪ್ರಮುಖವಾಗುತ್ತದೆ.
Imagine ಮಾಡಿ: ಒಂದು company ತನ್ನ internal HR policies, product manuals, customer support documents ಮತ್ತು technical documentation ಅನ್ನು AI assistantಗೆ connect ಮಾಡಿದೆ. Employee ಒಂದು ಪ್ರಶ್ನೆ ಕೇಳಿದಾಗ AI ತನ್ನ general knowledgeನಿಂದ ಮಾತ್ರ answer ಕೊಡುವುದಿಲ್ಲ. ಮೊದಲು connected knowledge baseನಲ್ಲಿ relevant information ಹುಡುಕುತ್ತದೆ. ನಂತರ ಆ information ಅನ್ನು LLMಗೆ context ಆಗಿ ಕೊಟ್ಟು answer generate ಮಾಡುತ್ತದೆ.
ಈ approachನ full name Retrieval-Augmented Generation, ಅಂದರೆ RAG.
ಸರಳವಾಗಿ ಹೇಳುವುದಾದರೆ:
RAG = Search + Relevant Information + AI Generation
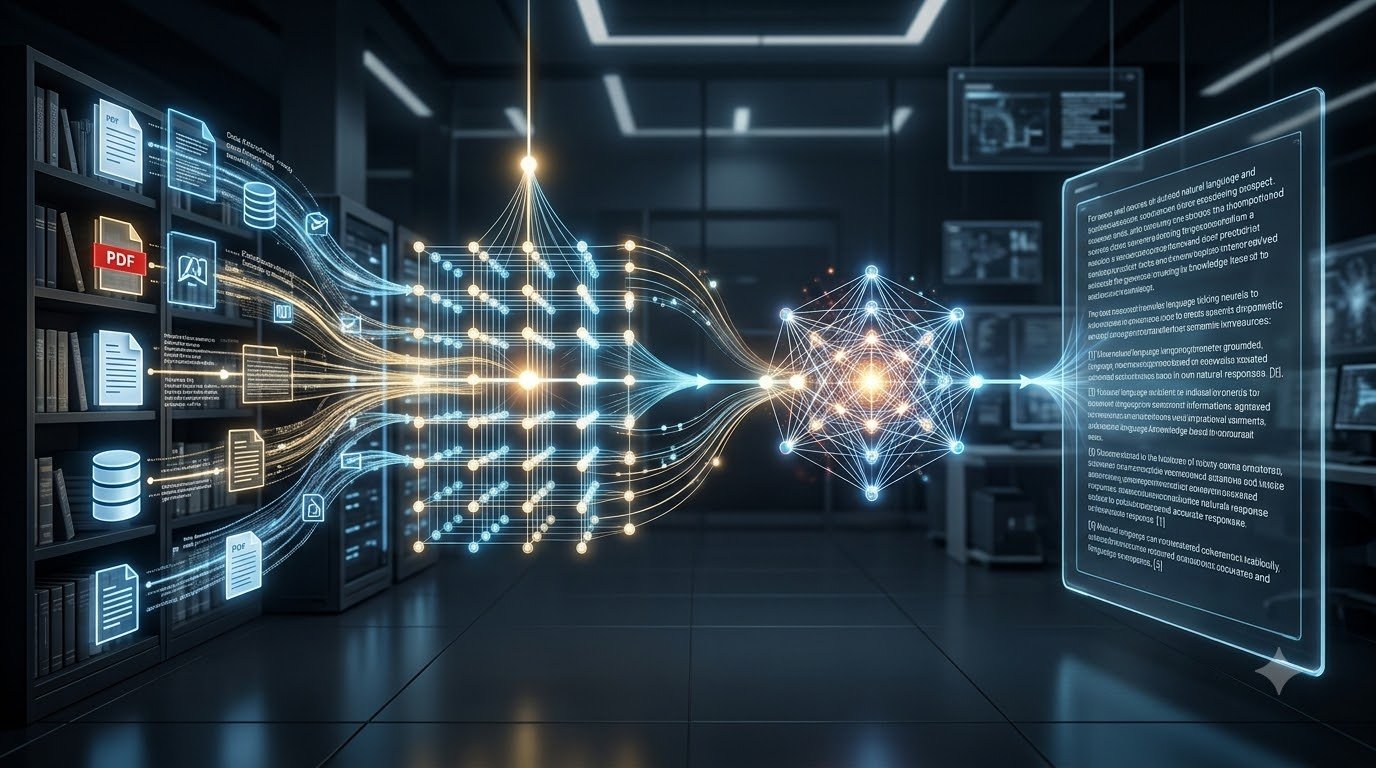
ಆದರೆ practical systemsನಲ್ಲಿ ಇದು ಕೇವಲ search ಮಾಡಿ answer ಕೊಡುವಷ್ಟು simple ಅಲ್ಲ. Documents ಅನ್ನು chunks ಆಗಿ split ಮಾಡುವುದು, embeddings create ಮಾಡುವುದು, vector databaseನಲ್ಲಿ store ಮಾಡುವುದು, relevant chunks retrieve ಮಾಡುವುದು, ranking ಮಾಡುವುದು, context ಅನ್ನು LLMಗೆ ಕೊಡುವುದು ಮತ್ತು final answer ಅನ್ನು grounded ಆಗಿ generate ಮಾಡುವುದು ಸೇರಿದಂತೆ ಹಲವು stages ಇರುತ್ತವೆ.
ಈ articleನಲ್ಲಿ RAG AI ಹೇಗೆ ಕೆಲಸ ಮಾಡುತ್ತದೆ, ಯಾಕೆ traditional LLMನಲ್ಲಿ ಇರುವ knowledge limitationಗೆ ಇದು useful, vector database ಮತ್ತು embeddingsನ role ಏನು, RAG ಮತ್ತು fine-tuning ನಡುವಿನ difference ಏನು, ಒಂದು practical RAG system ಹೇಗೆ build ಆಗುತ್ತದೆ ಮತ್ತು RAGನ limitations ಯಾವುವು ಎಂಬುದನ್ನು step-by-step ನೋಡೋಣ.
RAG AI ಎಂದರೇನು?
RAG AI ಎಂದರೆ ಒಂದು AI system ತನ್ನ answer generate ಮಾಡುವ ಮೊದಲು external knowledge sourceನಿಂದ relevant information retrieve ಮಾಡಿಕೊಂಡು, ಆ information ಅನ್ನು LLMಗೆ additional context ಆಗಿ ನೀಡುವ architecture.
Retrieval-Augmented Generation ಎಂಬ ಹೆಸರನ್ನೇ ಮೂರು ಭಾಗಗಳಾಗಿ ನೋಡಬಹುದು:
ಈ architectureನ original research background ಅನ್ನು ತಿಳಿಯಲು original RAG research paper ನೋಡಬಹುದು.
Retrieval
ಮೊದಲು relevant information ಹುಡುಕುವುದು.
Augmentation
ಹುಡುಕಿದ information ಅನ್ನು user’s question ಜೊತೆ ಸೇರಿಸಿ modelಗೆ additional context ನೀಡುವುದು.
Generation
ಆ context ಮತ್ತು user’s question ಆಧರಿಸಿ final answer generate ಮಾಡುವುದು.
ಅಂದರೆ traditional LLM workflow:
User Question → LLM → Answer
RAG workflow:
User Question → Retrieval → Relevant Context → LLM → Grounded Answer
ಇದು ಸಣ್ಣ differenceನಂತೆ ಕಾಣಬಹುದು. ಆದರೆ enterprise AI, customer support, internal knowledge assistants ಮತ್ತು domain-specific AI applicationsನಲ್ಲಿ ಈ architecture ಬಹಳ important.
LLMಗೆ RAG ಯಾಕೆ ಬೇಕು?
Large Language Model ಒಂದು huge amount of information ಮೇಲೆ trained ಆಗಿರಬಹುದು. ಆದರೆ training data ಮತ್ತು model knowledge ಕೆಲವು limitations ಹೊಂದಿರುತ್ತವೆ.
ಮೊದಲನೆಯದು knowledge cutoff ಅಥವಾ stale information.
Modelಗೆ training ಸಮಯದ ನಂತರ ನಡೆದ event ಗೊತ್ತಿರದೇ ಇರಬಹುದು.
ಎರಡನೆಯದು private information.
ನಿಮ್ಮ company’s internal documents, employee policies, customer database ಅಥವಾ private product documentation ಸಾಮಾನ್ಯ public training dataಯ ಭಾಗವಾಗಿರದೇ ಇರಬಹುದು.
ಮೂರನೆಯದು specialized knowledge.
ಒಂದು companyಗೆ ತನ್ನದೇ technical terminology, product architecture ಮತ್ತು internal processes ಇರಬಹುದು.
ನಾಲ್ಕನೆಯದು source grounding.
User ಕೇಳಿದ ಪ್ರಶ್ನೆಗೆ answer ಯಾವ document ಅಥವಾ source ಆಧರಿಸಿದೆ ಎಂಬುದು business applicationನಲ್ಲಿ ಬಹಳ important ಆಗಬಹುದು.
RAG ಈ problemಗಳನ್ನು address ಮಾಡಲು external knowledge ಅನ್ನು runtimeನಲ್ಲಿ retrieve ಮಾಡಿ modelಗೆ provide ಮಾಡುತ್ತದೆ.
Google Cloud ಕೂಡ RAG ಅನ್ನು retrieval system ಮತ್ತು generative modelನ combination ಎಂದು ವಿವರಿಸುತ್ತದೆ; retrieved information ಅನ್ನು modelಗೆ context ಆಗಿ ಸೇರಿಸುವುದು ಇದರ core workflow. OpenAIಯ retrieval ಮತ್ತು file-search systems ಕೂಡ semantic search ಮತ್ತು retrieved file content ಅನ್ನು model generationಗೆ ಬಳಸುವ ಇದೇ basic architecture ಅನ್ನು follow ಮಾಡುತ್ತವೆ.
RAG AI ಹೇಗೆ ಕೆಲಸ ಮಾಡುತ್ತದೆ?
ಒಂದು RAG system ಅನ್ನು simple ಆಗಿ ಎರಡು phasesನಲ್ಲಿ ನೋಡಬಹುದು:
Phase 1: Knowledge Preparation
Documents ಅನ್ನು AI-searchable formatಗೆ prepare ಮಾಡುವುದು.
Phase 2: Question Answering
User question ಬಂದಾಗ relevant information retrieve ಮಾಡಿ answer generate ಮಾಡುವುದು.
ಈ ಎರಡು phases ಅರ್ಥಮಾಡಿಕೊಂಡರೆ RAG architecture ಬಹಳ clear ಆಗುತ್ತದೆ.
RAG architectureನ Retrieve, Augment ಮತ್ತು Generate workflow ಅನ್ನು ಇನ್ನಷ್ಟು technical ಆಗಿ ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು Google Cloud RAG guide ನೋಡಬಹುದು.
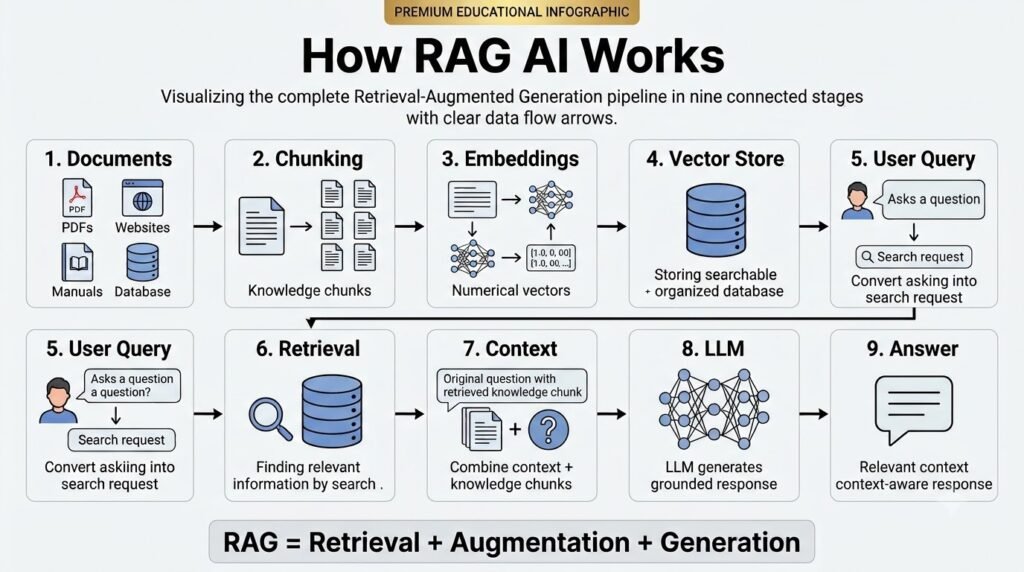
Phase 1: Knowledge Preparation
1. Documents Collect ಮಾಡುವುದು
ಮೊದಲು AIಗೆ knowledge source ಬೇಕು.
ಇವು:
- PDF documents
- Word files
- Web pages
- Product manuals
- FAQs
- Company policies
- Research papers
- Support documentation
- Internal knowledge bases
- Database records
ಯಾವುದಾದರೂ ಆಗಬಹುದು.
ಉದಾಹರಣೆಗೆ ಒಂದು hotel company ತನ್ನ employeesಗಾಗಿ AI assistant build ಮಾಡುತ್ತಿದೆ ಎಂದುಕೊಳ್ಳಿ.
ಅವರ knowledge baseನಲ್ಲಿ:
Employee handbook
Leave policy
Food safety manual
Hotel SOPs
Training documents
Emergency procedures
ಇರಬಹುದು.
ಈ documentsನೇ RAG systemನ knowledge source.
2. Documents ಅನ್ನು Chunks ಆಗಿ Split ಮಾಡುವುದು
ಒಂದು 300-page PDF ಅನ್ನು entire document ಆಗಿ search ಮಾಡುವುದು efficient ಆಗುವುದಿಲ್ಲ.
ಆದ್ದರಿಂದ document ಅನ್ನು ಸಣ್ಣ sections ಅಥವಾ chunks ಆಗಿ split ಮಾಡಲಾಗುತ್ತದೆ.
ಉದಾಹರಣೆಗೆ:
Document:
Employee Leave Policy
ಅದನ್ನು:
Chunk 1 — Annual Leave
Chunk 2 — Sick Leave
Chunk 3 — Casual Leave
Chunk 4 — Leave Approval
Chunk 5 — Emergency Leave
ಎಂದು split ಮಾಡಬಹುದು.
ಇಲ್ಲಿ ಒಂದು important engineering decision ಇದೆ.
Chunk size.
Chunk ತುಂಬಾ ಚಿಕ್ಕದಾದರೆ context ಕಳೆದುಹೋಗಬಹುದು.
ತುಂಬಾ ದೊಡ್ಡದಾದರೆ retrievalನಲ್ಲಿ unnecessary information ಬರಬಹುದು.
ಆದ್ದರಿಂದ chunk size, overlap ಮತ್ತು boundaries RAG quality ಮೇಲೆ ಪರಿಣಾಮ ಬೀರುತ್ತವೆ.
3. Embeddings Create ಮಾಡುವುದು
ಇದು RAG systemನ ಅತ್ಯಂತ important conceptsಗಳಲ್ಲಿ ಒಂದು.
ಪ್ರತಿಯೊಂದು chunk ಅನ್ನು embedding model ಮೂಲಕ numerical representation ಆಗಿ convert ಮಾಡಲಾಗುತ್ತದೆ.
ಈ numerical representation ಅನ್ನು vector ಎಂದು ಕರೆಯಬಹುದು.
ಉದಾಹರಣೆಗೆ:
“Employees can apply for annual leave through the HR portal.”
ಎಂಬ sentenceಗೆ embedding model ಒಂದು high-dimensional numerical representation create ಮಾಡುತ್ತದೆ.
ಇದರಿಂದ computerಗೆ sentenceನ meaning ಮತ್ತು semantic relationship ಅನ್ನು mathematical spaceನಲ್ಲಿ represent ಮಾಡಲು ಸಾಧ್ಯವಾಗುತ್ತದೆ.
ಇದನ್ನು keyword searchಗಿಂತ different ಆಗಿ ಅರ್ಥಮಾಡಿಕೊಳ್ಳಬೇಕು.
User:
“How can I take my yearly vacation?”
ಎಂದು ಕೇಳಿದಾಗ documentನಲ್ಲಿ exact phrase “yearly vacation” ಇರದೇ ಇರಬಹುದು.
ಆದರೂ:
“Employees can apply for annual leave…”
ಎಂಬ chunk semantic similarity ಮೂಲಕ relevant ಎಂದು retrieve ಆಗಬಹುದು.
ಇದು embeddingsನ ಪ್ರಮುಖ value.
4. Vector Databaseನಲ್ಲಿ Store ಮಾಡುವುದು
Embeddings create ಮಾಡಿದ ನಂತರ ಅವುಗಳನ್ನು ಸಾಮಾನ್ಯವಾಗಿ vector database ಅಥವಾ vector storeನಲ್ಲಿ store ಮಾಡಲಾಗುತ್ತದೆ.
Vector databaseನಲ್ಲಿ ಸಾಮಾನ್ಯವಾಗಿ:
- Text chunk
- Embedding
- Document metadata
- Source information
- Access information
ಹೀಗೆ data ಇರುತ್ತದೆ.
ಉದಾಹರಣೆಗೆ:
Chunk: Annual leave application procedure
Embedding: Numerical vector
Metadata: HR Policy / 2026 / Employee
ನಂತರ user query ಬಂದಾಗ system ಈ vector storeನಲ್ಲಿ relevant chunks ಹುಡುಕುತ್ತದೆ.
Vector stores ಮತ್ತು semantic search ಹೇಗೆ ಕೆಲಸ ಮಾಡುತ್ತವೆ ಎಂಬುದನ್ನು technical levelನಲ್ಲಿ ನೋಡಲು OpenAI Retrieval Guide ಉಪಯುಕ್ತ reference ಆಗಿದೆ.
Phase 2: Question Answering
ಈಗ actual RAG workflow ಶುರುವಾಗುತ್ತದೆ.
5. User Question
User ಒಂದು ಪ್ರಶ್ನೆ ಕೇಳುತ್ತಾನೆ:
“How many days of annual leave can an employee take?”
System ಮೊದಲು ಈ question ಅನ್ನು process ಮಾಡುತ್ತದೆ.
ಇದು direct answer generate ಮಾಡುವುದಿಲ್ಲ.
ಮೊದಲು knowledge baseನಲ್ಲಿ ಹುಡುಕುತ್ತದೆ.
6. Query ಅನ್ನು Search ಮಾಡುವುದು
User questionನಿಂದ retrieval system relevant documents ಅಥವಾ chunks ಹುಡುಕುತ್ತದೆ.
ಇಲ್ಲಿ two major approaches ಕಾಣಬಹುದು:
Semantic Search
Meaning ಆಧರಿಸಿ relevant information ಹುಡುಕುವುದು.
Keyword Search
Exact words ಅಥವಾ terms match ಮಾಡುವುದು.
Modern retrieval systems ಎರಡನ್ನೂ combine ಮಾಡಬಹುದು.
ಇದನ್ನು Hybrid Search ಎಂದು ಕರೆಯಬಹುದು.
ಇದು particularly technical documentationನಲ್ಲಿ useful.
ಉದಾಹರಣೆಗೆ user:
“Error code TS-999”
ಎಂದು ಕೇಳಿದರೆ semantic search general error documentation ಹುಡುಕಬಹುದು.
ಆದರೆ exact keyword matching TS-999 ಇರುವ precise document ಅನ್ನು identify ಮಾಡಲು ಸಹಾಯ ಮಾಡಬಹುದು.
ಈ ಕಾರಣದಿಂದ hybrid retrieval ಹಲವು practical systemsನಲ್ಲಿ useful.
7. Relevant Chunks Retrieve ಮಾಡುವುದು
Search system ಎಲ್ಲ documents ಅನ್ನು LLMಗೆ ಕಳುಹಿಸುವುದಿಲ್ಲ.
ಅದು top relevant chunks ಅನ್ನು select ಮಾಡುತ್ತದೆ.
ಉದಾಹರಣೆಗೆ:
User Question → 1,000 documents → Search → Top 5 relevant chunks
ಈ top chunks ಅನ್ನು ನಂತರ model contextಗೆ ಸೇರಿಸಲಾಗುತ್ತದೆ.
ಇಲ್ಲಿ retrieval quality ಅತ್ಯಂತ important.
Wrong chunk retrieve ಆದರೆ final answer fluent ಆಗಿದ್ದರೂ wrong ಆಗಿರಬಹುದು.
ಅದಕ್ಕಾಗಿಯೇ RAGನಲ್ಲಿ retrieval quality = answer qualityನ ಪ್ರಮುಖ ಭಾಗ.
8. Re-ranking
ಕೆಲವು advanced RAG systemsನಲ್ಲಿ initial retrieval ನಂತರ re-ranking ಮಾಡಲಾಗುತ್ತದೆ.
ಮೊದಲ search 20 potentially relevant chunks ತಂದಿದೆ ಎಂದುಕೊಳ್ಳಿ.
ಅವುಗಳಲ್ಲಿ:
- Chunk 1 — highly relevant
- Chunk 2 — highly relevant
- Chunk 3 — partially relevant
- Chunk 4 — unrelated
- Chunk 5 — highly relevant
ಹೀಗೆ relevance score ಆಧರಿಸಿ reorder ಮಾಡಬಹುದು.
ನಂತರ top results ಮಾತ್ರ LLMಗೆ ಕಳುಹಿಸಲಾಗುತ್ತದೆ.
ಇದು unnecessary context ಕಡಿಮೆ ಮಾಡಲು ಸಹಾಯ ಮಾಡುತ್ತದೆ.
9. Retrieved Context ಅನ್ನು LLMಗೆ ನೀಡುವುದು
ಈಗ system:
User Question + Retrieved Context
ಎರಡನ್ನೂ combine ಮಾಡುತ್ತದೆ.
ಉದಾಹರಣೆಗೆ:
Question:
“Annual leave ಎಷ್ಟು ದಿನ?”
Retrieved context:
“Employees are entitled to 24 days of annual leave per calendar year…”
ಈ information ಅನ್ನು LLMಗೆ ನೀಡಲಾಗುತ್ತದೆ.
LLM ಈಗ ತನ್ನ general knowledge ಜೊತೆಗೆ retrieved company information ಅನ್ನು ಬಳಸಿಕೊಂಡು answer generate ಮಾಡುತ್ತದೆ.
10. Final Answer Generate ಮಾಡುವುದು
ಕೊನೆಯ ಹಂತದಲ್ಲಿ LLM answer generate ಮಾಡುತ್ತದೆ.
ಉದಾಹರಣೆಗೆ:
“Company policy ಪ್ರಕಾರ employeesಗೆ ಪ್ರತಿ calendar yearನಲ್ಲಿ 24 days annual leave entitlement ಇದೆ.”
ಈ answer company documentನ retrieved information ಆಧಾರದಲ್ಲಿ ಬಂದಿದೆ.
ಇದೇ grounded generationನ basic idea.
RAG AIನ Complete Workflow
ಒಂದು complete RAG system ಅನ್ನು ಈ ರೀತಿಯಾಗಿ ನೆನಪಿಟ್ಟುಕೊಳ್ಳಬಹುದು:
Documents
↓
Chunking
↓
Embeddings
↓
Vector Database
↓
User Query
↓
Retrieval
↓
Ranking / Re-ranking
↓
Relevant Context
↓
LLM
↓
Grounded Answer
ಈ workflowನಲ್ಲಿ LLM ಮಾತ್ರ ಮುಖ್ಯ component ಅಲ್ಲ.
Retrieval layer ಕೂಡ equally important.
RAG ಮತ್ತು ಸಾಮಾನ್ಯ Chatbot ನಡುವಿನ Difference
ಒಂದು ಸಾಮಾನ್ಯ chatbot ತನ್ನ model knowledge ಮತ್ತು conversation context ಆಧರಿಸಿ answer generate ಮಾಡಬಹುದು.
RAG-based chatbot external knowledge base ಅನ್ನು runtimeನಲ್ಲಿ search ಮಾಡುತ್ತದೆ.
Traditional Chatbot
User → LLM → Answer
RAG Chatbot
User → Search Knowledge Base → Retrieve Context → LLM → Answer
ಇದರಿಂದ company-specific information, private documents ಅಥವಾ frequently changing information ಇರುವ applicationsಗೆ RAG ಹೆಚ್ಚು useful ಆಗಬಹುದು.
RAG ಮತ್ತು Fine-Tuning ನಡುವಿನ Difference
ಇದು AI developersಗೆ ಬಹಳ important distinction.
RAG ಮತ್ತು Fine-tuning ಎರಡೂ modelಗೆ better task performance ಕೊಡಲು ಬಳಸಬಹುದು. ಆದರೆ ಅವುಗಳ purpose ಒಂದೇ ಅಲ್ಲ.
RAG
RAGನಲ್ಲಿ external information runtimeನಲ್ಲಿ retrieve ಮಾಡಲಾಗುತ್ತದೆ.
ನಿಮ್ಮ knowledge base update ಮಾಡಿದರೆ retrieval layer ಹೊಸ information ಬಳಸಬಹುದು.
Fine-Tuning
Fine-tuningನಲ್ಲಿ model parameters ಅನ್ನು additional training data ಮೂಲಕ adapt ಮಾಡಲಾಗುತ್ತದೆ.
ಇದು modelನ behavior, style, task performance ಅಥವಾ domain-specific patterns improve ಮಾಡಲು ಬಳಸಬಹುದು.
Simple Example
ನಿಮ್ಮ companyಗೆ:
“Company policies ಬಗ್ಗೆ AI answer ಕೊಡಬೇಕು.”
ಎಂದರೆ RAG logical approach ಆಗಿರಬಹುದು.
ಆದರೆ:
“AI customer support responses ಯಾವ tone ಮತ್ತು formatನಲ್ಲಿ ಬರೆಯಬೇಕು?”
ಎಂಬ behavior customization ಬೇಕಾದರೆ fine-tuning ಅಥವಾ other model customization techniques relevant ಆಗಬಹುದು.
ಅಂದರೆ:
RAG = Knowledge access
Fine-tuning = Model behavior/task adaptation
ಕೆಲವು advanced systemsನಲ್ಲಿ ಎರಡನ್ನೂ combine ಮಾಡಬಹುದು.
RAG AI ಎಲ್ಲೆಲ್ಲಿ ಬಳಸಬಹುದು?
RAGನ practical applications ಬಹಳ ದೊಡ್ಡವು.
1. Customer Support
Customer ಪ್ರಶ್ನೆ ಕೇಳಿದಾಗ AI product manuals, FAQs ಮತ್ತು support documentation retrieve ಮಾಡಿ answer ಕೊಡಬಹುದು.
ಇದರಿಂದ support agentಗೆ ಪ್ರತಿಯೊಂದು document manually search ಮಾಡುವ ಅಗತ್ಯ ಕಡಿಮೆಯಾಗಬಹುದು.
2. Company Internal AI Assistant
Employee:
“ನನ್ನ leave policy ಏನು?”
AI:
Company HR documents search ಮಾಡಿ answer ಕೊಡಬಹುದು.
ಇದು general chatbotಗಿಂತ ಹೆಚ್ಚು useful ಏಕೆಂದರೆ answer company-specific knowledge ಆಧಾರದಲ್ಲಿರುತ್ತದೆ.
3. Legal Document Search
Law firmನಲ್ಲಿ thousands of documents ಇರಬಹುದು.
RAG system relevant clauses, cases ಅಥವಾ documents retrieve ಮಾಡಲು ಸಹಾಯ ಮಾಡಬಹುದು.
ಆದರೆ legal decisionsಗೆ human professional review ಅಗತ್ಯ.
RAG information retrieval ಮತ್ತು summarizationಗೆ ಸಹಾಯ ಮಾಡಬಹುದು; ಅದು legal judgementಗೆ replacement ಅಲ್ಲ.
4. Healthcare Knowledge Systems
Medical literature, clinical guidelines ಅಥವಾ institutional documentation search ಮಾಡಲು RAG useful ಆಗಬಹುದು.
ಆದರೆ healthcareನಲ್ಲಿ retrieved information quality, source freshness ಮತ್ತು professional validation ಅತ್ಯಂತ critical.
5. E-commerce
Customer:
“ಈ product waterproof ಆಗಿದೆಯೇ?”
RAG system product specifications retrieve ಮಾಡಿ answer ಕೊಡಬಹುದು.
6. Education
Students ಒಂದು textbook ಅಥವಾ course material ಆಧರಿಸಿ questions ಕೇಳಬಹುದು.
RAG system textbookನಲ್ಲಿ relevant section ಹುಡುಕಿ explanation ಕೊಡಬಹುದು.
ಇದು personalized learning workflowsಗೆ useful.
7. Research
Research papers ದೊಡ್ಡ knowledge base ಆಗಬಹುದು.
RAG system:
Paper search
Relevant passages
Research summary
Comparison
Question answering
ಹೀಗೆ research workflowನಲ್ಲಿ ಸಹಾಯ ಮಾಡಬಹುದು.
Research workflowsನಲ್ಲಿ AI ಹೇಗೆ scientific knowledge ಜೊತೆ ಕೆಲಸ ಮಾಡುತ್ತಿದೆ ಎಂಬುದನ್ನು ತಿಳಿಯಲು ನಮ್ಮ AI Scientific Discovery article ಕೂಡ ಓದಬಹುದು.
RAG AI ಯಾಕೆ Hallucination ಕಡಿಮೆ ಮಾಡಲು ಸಹಾಯ ಮಾಡುತ್ತದೆ?
LLMs sometimes plausible-looking but incorrect information generate ಮಾಡಬಹುದು.
RAGನಲ್ಲಿ modelಗೆ relevant source context ನೀಡುವುದರಿಂದ answer ಅನ್ನು retrieved evidenceಗೆ ground ಮಾಡುವ ಅವಕಾಶ ಸಿಗುತ್ತದೆ.
ಆದರೆ ಇಲ್ಲಿ ಒಂದು important point:
RAG hallucination ಅನ್ನು completely eliminate ಮಾಡುವುದಿಲ್ಲ.
ಇದು common misconception.
Suppose retrieval system wrong document ತಂದಿತು.
LLM ಆ wrong documentನ information ಆಧರಿಸಿ fluent answer generate ಮಾಡಬಹುದು.
ಅಥವಾ retrieved documentನಲ್ಲಿ answer ಇರದೇ ಇದ್ದರೂ model ತನ್ನ own knowledge ಬಳಸಿ answer invent ಮಾಡಬಹುದು.
ಆದ್ದರಿಂದ RAGನಲ್ಲಿ:
Good Retrieval + Good Prompting + Good Source Data + Good Evaluation
ಎಲ್ಲವೂ ಬೇಕಾಗುತ್ತದೆ.
RAG AIನಲ್ಲಿ Biggest Challenge: Retrieval Quality
RAG system build ಮಾಡುವಾಗ developers ಕೆಲವೊಮ್ಮೆ LLM ಮೇಲೆ ಹೆಚ್ಚು focus ಮಾಡುತ್ತಾರೆ.
ಆದರೆ retrieval layer weak ಆಗಿದ್ದರೆ best LLM ಕೂಡ wrong contextನಿಂದ poor answer ಕೊಡಬಹುದು.
ಇದನ್ನು ಹೀಗೆ ಅರ್ಥಮಾಡಿಕೊಳ್ಳಿ.
ಒಬ್ಬ studentಗೆ exam question ಬಂದಿದೆ.
ಅವನ ಬಳಿ 1,000-page textbook ಇದೆ.
ಆದರೆ ಅವನು wrong chapter ತೆರೆದು answer ಬರೆಯಲು ಶುರು ಮಾಡಿದರೆ, ಅವನು ಎಷ್ಟು intelligent ಆಗಿದ್ದರೂ final answer problem ಆಗಬಹುದು.
RAG systemಗೂ ಇದೇ logic.
Wrong retrieval → Wrong context → Wrong answer
ಆದ್ದರಿಂದ document quality, chunking, embeddings, search strategy ಮತ್ತು ranking ಎಲ್ಲವೂ important.
RAG systemನಲ್ಲಿ source data quality ಮತ್ತು reliability ಕೂಡ important ಆಗಿರುವುದರಿಂದ AI Data Observability ಬಗ್ಗೆ ತಿಳಿದುಕೊಳ್ಳುವುದು useful.
Chunking ಯಾಕೆ ಇಷ್ಟು Important?
Chunking simple technical preprocessing stepನಂತೆ ಕಾಣಬಹುದು.
ಆದರೆ ಇದು retrieval qualityಗೆ ದೊಡ್ಡ impact ಕೊಡಬಹುದು.
Suppose document:
“Company Remote Work Policy”
ಅದನ್ನು ತುಂಬಾ small chunksಗೆ split ಮಾಡಿದರೆ ಒಂದು chunkನಲ್ಲಿ:
“Employees may work remotely…”
ಮಾತ್ರ ಇರಬಹುದು.
ಆದರೆ ಅದರ ಮುಂದಿನ chunkನಲ್ಲಿ eligibility conditions ಇರಬಹುದು.
ಈ ಎರಡು pieces separate ಆಗಿದ್ದರೆ retrieval system incomplete context retrieve ಮಾಡಬಹುದು.
ಅದೇ ಸಮಯದಲ್ಲಿ chunk ತುಂಬಾ ದೊಡ್ಡದಾದರೆ irrelevant content ಕೂಡ modelಗೆ ಹೋಗಬಹುದು.
ಅದಕ್ಕಾಗಿಯೇ practical RAG systemsನಲ್ಲಿ:
- Chunk size
- Chunk overlap
- Section boundaries
- Metadata
- Document structure
carefully design ಮಾಡಬೇಕು.
Contextual Retrieval ಎಂದರೇನು?
Traditional RAGನಲ್ಲಿ document chunks independently embed ಮಾಡಲಾಗುತ್ತದೆ.
ಇಲ್ಲಿ problem ಏನೆಂದರೆ chunk ತನ್ನ original document context ಕಳೆದುಕೊಳ್ಳಬಹುದು.
Anthropic ತನ್ನ Contextual Retrieval approachನಲ್ಲಿ chunkಗೆ document-level context ಸೇರಿಸಿ retrieval quality improve ಮಾಡುವ ವಿಧಾನವನ್ನು ವಿವರಿಸಿದೆ.
ಉದಾಹರಣೆಗೆ:
Original chunk:
“Revenue increased by 3% compared with the previous quarter.”
ಇದು ಯಾವ company? ಯಾವ quarter? ಯಾವ report?
ಎಂಬುದು clear ಆಗದೇ ಇರಬಹುದು.
Context ಸೇರಿಸಿದ version:
“This chunk is from ACME Corp’s Q2 2023 financial filing…”
ಎಂಬ ರೀತಿಯಲ್ಲಿ ಹೆಚ್ಚು context-rich ಆಗಬಹುದು.
ಇದರಿಂದ retrieval systemಗೆ chunkನ meaning ಹೆಚ್ಚು clear ಆಗಬಹುದು.
ಇದು RAG systems ಹೇಗೆ evolve ಆಗುತ್ತಿವೆ ಎಂಬುದಕ್ಕೆ ಒಳ್ಳೆಯ example.
Anthropicನ Contextual Retrieval approach ಬಗ್ಗೆ technical details ಮತ್ತು retrieval experiments ಅನ್ನು ಇಲ್ಲಿ ನೋಡಬಹುದು.
RAGನಲ್ಲಿ Vector Database ಮಾತ್ರ ಸಾಕೇ?
ಇಲ್ಲ.
Vector database RAG architectureನ ಒಂದು component ಮಾತ್ರ.
ಒಂದು production RAG systemನಲ್ಲಿ ಸಾಮಾನ್ಯವಾಗಿ:
Data Sources
↓
Document Processing
↓
Chunking
↓
Embedding Model
↓
Vector Store
↓
Retriever
↓
Re-ranker
↓
Prompt / Context Builder
↓
LLM
↓
Answer + Citations
ಹೀಗೆ multiple layers ಇರಬಹುದು.
ಇದರರ್ಥ ಒಂದು vector database install ಮಾಡಿದರೆ RAG system ready ಆಗುವುದಿಲ್ಲ.
Actual quality retrieval pipeline ಮೇಲೆ depend ಆಗುತ್ತದೆ.
RAGನಲ್ಲಿ Metadata ಯಾಕೆ Important?
Suppose company knowledge baseನಲ್ಲಿ 10,000 documents ಇವೆ.
ಅವು:
HR
Finance
Engineering
Sales
Legal
Marketing
ಎಂಬ departmentsಗೆ ಸೇರಿದವು.
User ಕೇಳುತ್ತಾನೆ:
“Engineering teamಗೆ remote work policy ಏನು?”
Retrieval systemಗೆ metadata filters ಬಳಸಲು ಸಾಧ್ಯವಾದರೆ relevant department documentsಗೆ search scope reduce ಮಾಡಬಹುದು.
Metadata examples:
- Department
- Document type
- Date
- Product
- Region
- Language
- Access level
ಇವು retrieval quality ಮತ್ತು security ಎರಡಕ್ಕೂ useful.
RAG ಮತ್ತು Access Control
Enterprise RAGನಲ್ಲಿ security ಬಹಳ important.
Suppose companyನಲ್ಲಿ confidential salary document ಇದೆ.
ಒಬ್ಬ employee ಸಾಮಾನ್ಯ company chatbotನಲ್ಲಿ query ಮಾಡಿದಾಗ salary document retrieve ಆಗಬಾರದು.
ಆದ್ದರಿಂದ RAG systemನಲ್ಲಿ:
Who can retrieve what?
ಎಂಬ permission layer ಇರಬೇಕು.
ಇದು ಕೇವಲ LLM promptನಲ್ಲಿ “don’t reveal confidential information” ಎಂದು ಬರೆಯುವುದರಿಂದ solve ಆಗುವುದಿಲ್ಲ.
Retrieval layerನಲ್ಲಿಯೇ access control enforce ಮಾಡುವುದು ಹೆಚ್ಚು robust architecture ಆಗಬಹುದು.
RAG AIನಲ್ಲಿ Citations ಯಾಕೆ Valuable?
RAG application answer ಜೊತೆಗೆ source reference ಕೊಡಲು ಸಾಧ್ಯವಾದರೆ userಗೆ information verify ಮಾಡಲು ಸುಲಭವಾಗುತ್ತದೆ.
ಉದಾಹರಣೆಗೆ:
Answer:
Annual leave entitlement is 24 days.
Source:
Employee Handbook, Section 4.2
ಇದರಿಂದ user:
- Answer verify ಮಾಡಬಹುದು
- Original document open ಮಾಡಬಹುದು
- Context check ಮಾಡಬಹುದು
- Trust improve ಮಾಡಬಹುದು
Especially enterprise, research, legal ಮತ್ತು technical applicationsನಲ್ಲಿ citations ಬಹಳ valuable.
RAG AI Build ಮಾಡಲು ಏನು ಬೇಕು?
ಒಂದು basic RAG application build ಮಾಡಲು ಸಾಮಾನ್ಯವಾಗಿ ಈ components ಬೇಕಾಗುತ್ತವೆ:
1. Knowledge Source
PDFs, documents, websites ಅಥವಾ databases.
2. Document Processor
Documents ಅನ್ನು clean ಮತ್ತು chunk ಮಾಡಲು.
3. Embedding Model
Text chunks ಅನ್ನು vectorsಗೆ convert ಮಾಡಲು.
4. Vector Store
Embeddings store ಮತ್ತು search ಮಾಡಲು.
5. Retrieval Layer
User queryಗೆ relevant chunks retrieve ಮಾಡಲು.
6. LLM
Retrieved context ಆಧರಿಸಿ answer generate ಮಾಡಲು.
7. Evaluation
System ನಿಜವಾಗಿಯೂ relevant information retrieve ಮಾಡುತ್ತಿದೆಯೇ ಮತ್ತು correct answer ಕೊಡುತ್ತಿದೆಯೇ ಎಂದು test ಮಾಡಲು.
No-Code RAG ಕೂಡ ಸಾಧ್ಯವೇ?
ಹೌದು.
RAG architecture ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು developer ಆಗಿರಬೇಕೆಂಬುದಿಲ್ಲ.
ಕೆಲವು AI platforms ಮತ್ತು enterprise tools documents upload ಮಾಡಿ knowledge-based AI assistants build ಮಾಡಲು tools ಒದಗಿಸುತ್ತವೆ.
ಉದಾಹರಣೆಗೆ, OpenAIಯ File Search tool uploaded filesನಿಂದ semantic ಮತ್ತು keyword search ಮೂಲಕ relevant information retrieve ಮಾಡಿ modelಗೆ provide ಮಾಡಲು designed ಆಗಿದೆ.
ಇದರ basic concept:
Upload Knowledge → Search Relevant Information → Give Context to Model → Generate Answer
ಆದರೆ production-grade RAG systemನಲ್ಲಿ access control, evaluation, metadata filtering, retrieval tuning ಮತ್ತು monitoring ಮುಂತಾದ advanced layers ಬೇಕಾಗಬಹುದು.
ನಿಮ್ಮದೇ personal AI assistant build ಮಾಡುವ practical workflow ಬಗ್ಗೆ ತಿಳಿಯಲು ನಮ್ಮ no-code AI assistant guide ಓದಬಹುದು.
ಈ ರೀತಿಯ document-based retrieval workflowಗೆ practical example ಆಗಿ OpenAI File Search documentation ನೋಡಬಹುದು. ಇದು uploaded filesನಿಂದ semantic ಮತ್ತು keyword search ಮೂಲಕ relevant information retrieve ಮಾಡಿ modelಗೆ context ಆಗಿ ಬಳಸಲು ಸಹಾಯ ಮಾಡುತ್ತದೆ.
RAG AIನಲ್ಲಿ Common Mistakes
1. Bad Documents ಅನ್ನು RAGಗೆ ಹಾಕುವುದು
Garbage in, garbage out.
Outdated ಅಥವಾ contradictory documents ಇದ್ದರೆ AI answer ಕೂಡ unreliable ಆಗಬಹುದು.
2. Chunking ಅನ್ನು Ignore ಮಾಡುವುದು
ಎಲ್ಲ documentsಗೆ ಒಂದೇ chunk size ಬಳಸುವುದು ಯಾವಾಗಲೂ optimal ಆಗುವುದಿಲ್ಲ.
3. Top-K Results ತುಂಬಾ ಹೆಚ್ಚು ಮಾಡುವುದು
More context always means better answer ಅಲ್ಲ.
ಹೆಚ್ಚು irrelevant chunks modelಗೆ distraction ಕೊಡಬಹುದು.
4. Retrieval ಅನ್ನು Evaluate ಮಾಡದೇ ಇರುವುದು
Answer correct ಆಗಿದೆಯೇ ಮಾತ್ರ ನೋಡಬೇಡಿ.
ಮೊದಲು:
Correct document retrieve ಆಗಿದೆಯೇ?
ಎಂದು ಪರೀಕ್ಷಿಸಬೇಕು.
5. Access Control Ignore ಮಾಡುವುದು
Private company data ಇರುವ RAGನಲ್ಲಿ ಇದು serious security problem ಆಗಬಹುದು.
6. Citations ಇಲ್ಲದೇ ಇರುವುದು
Important enterprise use casesನಲ್ಲಿ source traceability ಕಡಿಮೆಯಾಗಬಹುದು.
7. RAG ಅನ್ನು Hallucination Cure ಎಂದು ಭಾವಿಸುವುದು
RAG risk ಕಡಿಮೆ ಮಾಡಲು ಸಹಾಯ ಮಾಡಬಹುದು.
ಆದರೆ perfect accuracy guarantee ಮಾಡುವುದಿಲ್ಲ.
RAG AI ಅನ್ನು Evaluate ಹೇಗೆ ಮಾಡಬೇಕು?
Production RAG systemನಲ್ಲಿ evaluation ಬಹಳ important.
ಕನಿಷ್ಠ ಈ ನಾಲ್ಕು questions ಕೇಳಬೇಕು:
Retrieval Relevance
Correct information retrieve ಆಗಿದೆಯೇ?
Context Precision
Retrieved chunksನಲ್ಲಿ unnecessary information ಎಷ್ಟು ಇದೆ?
Groundedness
Final answer retrieved contextಗೆ supported ಆಗಿದೆಯೇ?
Answer Quality
User ಪ್ರಶ್ನೆಗೆ final answer actually useful ಆಗಿದೆಯೇ?
ಒಂದು RAG systemನಲ್ಲಿ LLM quality ಮಾತ್ರ measure ಮಾಡಿದರೆ complete picture ಸಿಗುವುದಿಲ್ಲ.
Retrieval ಮತ್ತು generation ಎರಡನ್ನೂ separately evaluate ಮಾಡಬೇಕು.
RAG AI ಮತ್ತು AI Agents ನಡುವಿನ Connection
AI Agent ಒಂದು task complete ಮಾಡಲು tools, planning ಮತ್ತು external information ಬಳಸಬಹುದು.
RAG agentಗೆ knowledge access layer ಆಗಿ ಕೆಲಸ ಮಾಡಬಹುದು.
ಉದಾಹರಣೆಗೆ ಒಂದು customer-support agent:
User Question
↓
Agent Understands Request
↓
RAG Searches Product Knowledge
↓
Relevant Documentation Retrieved
↓
Agent Decides Next Action
↓
Response Generated
ಇಲ್ಲಿ RAG “brain” ಅಲ್ಲ.
ಅದು agentಗೆ trusted knowledge access mechanism ಆಗಿ ಕೆಲಸ ಮಾಡುತ್ತದೆ.
Agent architecture ಮತ್ತು knowledge retrieval combine ಆದಾಗ ಹೆಚ್ಚು sophisticated AI systems build ಮಾಡಬಹುದು.
RAG ಅನ್ನು AI agents ಜೊತೆ combine ಮಾಡಿದಾಗ agentಗೆ external knowledge access ನೀಡಬಹುದು; AI agent architecture ಮತ್ತು MCP ಬಗ್ಗೆ ಇನ್ನಷ್ಟು ತಿಳಿಯಲು ನಮ್ಮ detailed guide ನೋಡಬಹುದು.
RAG AI ಮುಂದಿನ ಹಂತದಲ್ಲಿ ಹೇಗೆ ಬೆಳೆಯಬಹುದು?
RAG ಈಗ simple vector searchನಿಂದ ಹೆಚ್ಚು advanced retrieval architectures ಕಡೆಗೆ move ಆಗುತ್ತಿದೆ.
Future-oriented RAG systemsನಲ್ಲಿ:
- Hybrid Search
- Re-ranking
- Contextual Retrieval
- Metadata Filtering
- Multimodal Retrieval
- Graph-based Retrieval
- Agentic Retrieval
- Query Rewriting
- Source Verification
- Better Evaluation
ಮುಂತಾದ techniques ಬಳಸಬಹುದು.
ಉದಾಹರಣೆಗೆ, user ಪ್ರಶ್ನೆ ambiguous ಆಗಿದ್ದರೆ system ಮೊದಲು query rewrite ಮಾಡಬಹುದು.
ನಂತರ multiple searches ನಡೆಸಬಹುದು.
ಅದರ ನಂತರ results compare ಮಾಡಿ best evidence select ಮಾಡಬಹುದು.
ಇದು simple:
Query → Search → Answer
workflowಗಿಂತ ಹೆಚ್ಚು intelligent retrieval pipeline ಆಗುತ್ತದೆ.
RAG AI ಮತ್ತು Multimodal Knowledge
RAG ಕೇವಲ text documentsಗೆ ಸೀಮಿತವಾಗಬೇಕೆಂದಿಲ್ಲ.
Modern AI systemsನಲ್ಲಿ knowledge:
- Text
- Images
- Tables
- Audio
- Video
- PDFs
- Structured data
ರೂಪದಲ್ಲಿರಬಹುದು.
ಉದಾಹರಣೆಗೆ ಒಂದು machine maintenance assistantಗೆ manuals ಮಾತ್ರವಲ್ಲದೆ machine diagrams ಮತ್ತು maintenance images ಕೂಡ knowledge source ಆಗಬಹುದು.
User:
“ಈ machineನಲ್ಲಿ ಈ warning symbol ಏನು?”
ಎಂದು image upload ಮಾಡಿದರೆ system visual information ಮತ್ತು documentation ಎರಡನ್ನೂ combine ಮಾಡಬಹುದು.
ಇದು multimodal RAGಗೆ ಉದಾಹರಣೆ.
ಒಂದು Practical RAG Example
ಒಂದು online education companyಗೆ 500 course PDFs ಇವೆ ಎಂದುಕೊಳ್ಳಿ.
ಅವರು studentsಗಾಗಿ AI assistant build ಮಾಡುತ್ತಾರೆ.
Student ಕೇಳುತ್ತಾನೆ:
“Photosynthesisನಲ್ಲಿ light reaction ಯಾವ organelleನಲ್ಲಿ ನಡೆಯುತ್ತದೆ?”
System:
- Student question receive ಮಾಡುತ್ತದೆ.
- Question ಅನ್ನು retrieval query ಆಗಿ process ಮಾಡುತ್ತದೆ.
- Course PDFsನಲ್ಲಿ relevant chunks search ಮಾಡುತ್ತದೆ.
- Relevant Biology textbook section retrieve ಮಾಡುತ್ತದೆ.
- Retrieved context ಅನ್ನು LLMಗೆ ನೀಡುತ್ತದೆ.
- LLM answer generate ಮಾಡುತ್ತದೆ.
- Source section ಕೂಡ ತೋರಿಸಬಹುದು.
Studentಗೆ generic internet knowledgeಗಿಂತ ಅವರ course material ಆಧಾರಿತ answer ಸಿಗುತ್ತದೆ.
ಇದೇ RAGನ practical power.
RAG AI ಯಾಕೆ Modern AI Systemsಗೆ Important?
LLMs powerful ಆಗಿವೆ.
ಆದರೆ organizationsಗೆ ಒಂದು ಪ್ರಶ್ನೆ ಇದೆ:
“ನಮ್ಮ data ಜೊತೆ AI ಹೇಗೆ ಕೆಲಸ ಮಾಡುತ್ತದೆ?”
ಇಲ್ಲಿಯೇ RAG important ಆಗುತ್ತದೆ.
ಒಂದು organization ತನ್ನ private knowledge ಅನ್ನು model trainingಗೆ directly ಸೇರಿಸದೇ, retrieval layer ಮೂಲಕ relevant information runtimeನಲ್ಲಿ provide ಮಾಡಬಹುದು.
ಇದರಿಂದ knowledge updates ಕೂಡ comparatively easier ಆಗಬಹುದು.
ಉದಾಹರಣೆಗೆ company policy update ಮಾಡಿದರೆ knowledge base update ಮಾಡಿ retrieval system ಹೊಸ document ಬಳಸುವಂತೆ ಮಾಡಬಹುದು.
ಪ್ರತಿ ಬಾರಿ entire model ಅನ್ನು retrain ಮಾಡಬೇಕಾಗಿಲ್ಲ.
ಇದು RAGನ ಪ್ರಮುಖ architectural advantageಗಳಲ್ಲಿ ಒಂದು.
RAG AI ಕಲಿಯಲು Beginner-to-Midrange Roadmap
RAG concept ಕಲಿಯಲು ಈ order useful:
Step 1
LLM basics ಅರ್ಥಮಾಡಿಕೊಳ್ಳಿ.
Step 2
Embeddings ಅರ್ಥಮಾಡಿಕೊಳ್ಳಿ.
Step 3
Vector databases ಕಲಿಯಿರಿ.
Step 4
Semantic Search ಮತ್ತು Keyword Search difference ತಿಳಿಯಿರಿ.
Step 5
Chunking ಮತ್ತು metadata ಕಲಿಯಿರಿ.
Step 6
Basic RAG pipeline build ಮಾಡಿ.
Step 7
Retrieval evaluation ಕಲಿಯಿರಿ.
Step 8
Hybrid Search ಮತ್ತು re-ranking explore ಮಾಡಿ.
Step 9
RAG ಅನ್ನು AI Agent workflow ಜೊತೆ combine ಮಾಡಿ.
Step 10
Production security ಮತ್ತು monitoring ಕಲಿಯಿರಿ.
ಈ roadmap follow ಮಾಡಿದರೆ RAG ಕೇವಲ ಒಂದು buzzword ಆಗಿ ಉಳಿಯದೆ practical AI engineering concept ಆಗಿ ಅರ್ಥವಾಗುತ್ತದೆ.
RAG AI: Simple Mental Model
RAG ಅನ್ನು ಒಂದು digital librarian ಎಂದು imagine ಮಾಡಿ.
LLM ಒಬ್ಬ intelligent writer.
ಆದರೆ writerಗೆ libraryಯಲ್ಲಿರುವ 10,000 books ಎಲ್ಲವೂ ನೆನಪಿಲ್ಲ.
Librarian:
- Question ಕೇಳುತ್ತಾನೆ.
- Relevant books ಹುಡುಕುತ್ತಾನೆ.
- Correct pages select ಮಾಡುತ್ತಾನೆ.
- Writerಗೆ ಕೊಡುತ್ತಾನೆ.
- Writer ಆ information ಆಧರಿಸಿ answer ಬರೆಯುತ್ತಾನೆ.
ಇಲ್ಲಿ:
Librarian = Retrieval System
Books = Knowledge Base
Selected Pages = Retrieved Context
Writer = LLM
Final Answer = Generated Response
ಈ analogy ಅರ್ಥವಾದರೆ RAG architectureನ core idea ಬಹಳ ಸುಲಭ.
Final Takeaways
RAG AI modern AI applicationsನಲ್ಲಿ ಒಂದು important architecture ಆಗಿದೆ ಏಕೆಂದರೆ ಅದು LLMಗೆ external knowledge access ನೀಡುತ್ತದೆ.
ಇದರ core workflow:
Retrieve → Augment → Generate
ಆದರೆ production systemನಲ್ಲಿ ಅದರ ಹಿಂದೆ:
Documents → Chunking → Embeddings → Vector Store → Retrieval → Ranking → Context → LLM → Answer
ಎಂಬ complete pipeline ಇರುತ್ತದೆ.
RAGನ biggest strength ಎಂದರೆ modelಗೆ runtimeನಲ್ಲಿ relevant external information ನೀಡುವ ability.
ಇದು:
- Private company knowledge
- Product documentation
- Customer support
- Research papers
- Educational content
- Internal policies
- Technical documentation
ಹೀಗೆ ಹಲವು use casesನಲ್ಲಿ useful.
ಆದರೆ RAG perfect solution ಅಲ್ಲ.
Wrong documents, poor chunking, weak retrieval, bad ranking ಅಥವಾ outdated knowledge ಇದ್ದರೆ final answer ಕೂಡ unreliable ಆಗಬಹುದು.
ಅದಕ್ಕಾಗಿ RAG systemನ quality ಅನ್ನು LLM quality ಮಾತ್ರದಿಂದ ಅಳೆಯಬಾರದು.
Retrieval quality + source quality + grounding + evaluation + security
ಇವೆಲ್ಲವೂ equally important.
ಒಂದು sentenceನಲ್ಲಿ RAG ಅನ್ನು ನೆನಪಿಟ್ಟುಕೊಳ್ಳಬೇಕಾದರೆ:
RAG AI ಒಂದು LLMಗೆ “ಎಲ್ಲವೂ ನೆನಪಿರುವಂತೆ” ಮಾಡುವ technology ಅಲ್ಲ; ಅಗತ್ಯವಾದ ಸಮಯದಲ್ಲಿ ಸರಿಯಾದ knowledge ಹುಡುಕಿ, ಅದನ್ನು context ಆಗಿ ನೀಡಿ, ಅದರ ಆಧಾರದಲ್ಲಿ answer generate ಮಾಡಲು ಸಹಾಯ ಮಾಡುವ architecture.
ಅದೇ ಕಾರಣದಿಂದ RAG AI ಮುಂದಿನ generation knowledge-based assistants, enterprise AI systems ಮತ್ತು AI agentsಗೆ ಪ್ರಮುಖ foundation ಆಗಿ ಉಳಿಯುವ ಸಾಧ್ಯತೆ ಇದೆ.
FAQs
RAG AI ಎಂದರೇನು?
RAG AI ಎಂದರೆ Retrieval-Augmented Generation ಆಧಾರಿತ AI architecture. ಇದು answer generate ಮಾಡುವ ಮೊದಲು external knowledge sourceನಿಂದ relevant information retrieve ಮಾಡಿ LLMಗೆ context ಆಗಿ ನೀಡುತ್ತದೆ.
RAG ಹೇಗೆ ಕೆಲಸ ಮಾಡುತ್ತದೆ?
ಸಾಮಾನ್ಯವಾಗಿ documents ಅನ್ನು chunks ಆಗಿ split ಮಾಡಿ embeddings create ಮಾಡಲಾಗುತ್ತದೆ. ಅವುಗಳನ್ನು vector storeನಲ್ಲಿ index ಮಾಡಲಾಗುತ್ತದೆ. User query ಬಂದಾಗ relevant chunks retrieve ಮಾಡಿ LLMಗೆ context ಆಗಿ ನೀಡಲಾಗುತ್ತದೆ. ನಂತರ LLM final answer generate ಮಾಡುತ್ತದೆ.
RAG ಮತ್ತು Fine-Tuning ಒಂದೇನಾ?
ಇಲ್ಲ. RAG runtimeನಲ್ಲಿ external knowledge retrieve ಮಾಡುವ ವಿಧಾನ. Fine-tuning modelನ behavior ಅಥವಾ task performance adapt ಮಾಡಲು additional training ಬಳಸುತ್ತದೆ.
RAG hallucination ಸಂಪೂರ್ಣವಾಗಿ ತಡೆಯುತ್ತದೆಯೇ?
ಇಲ್ಲ. RAG relevant source context ಒದಗಿಸುವ ಮೂಲಕ hallucination risk ಕಡಿಮೆ ಮಾಡಲು ಸಹಾಯ ಮಾಡಬಹುದು. ಆದರೆ retrieval ತಪ್ಪಿದ್ದರೆ ಅಥವಾ source data ತಪ್ಪಿದ್ದರೆ model ಇನ್ನೂ incorrect answer ಕೊಡಬಹುದು.
RAGಗೆ Vector Database ಬೇಕೇ?
Traditional RAG implementationsನಲ್ಲಿ vector stores ಬಹಳ common. ಆದರೆ RAG architecture ಅನ್ನು vector databaseಗೆ ಮಾತ್ರ ಸೀಮಿತಗೊಳಿಸಲಾಗುವುದಿಲ್ಲ. Keyword search, hybrid search, databases ಮತ್ತು other retrieval mechanisms ಕೂಡ ಬಳಸಬಹುದು.
RAG AIಗೆ Embeddings ಯಾಕೆ ಬೇಕು?
Embeddings textನ semantic meaning ಅನ್ನು numerical representation ಆಗಿ encode ಮಾಡಲು ಸಹಾಯ ಮಾಡುತ್ತವೆ. ಇದರಿಂದ user queryಗೆ meaningನಲ್ಲಿ similar ಇರುವ document chunks retrieve ಮಾಡಬಹುದು.
RAG ಅನ್ನು AI Agents ಜೊತೆ ಬಳಸಬಹುದೇ?
ಹೌದು. RAG agentಗೆ external knowledge access layer ಆಗಿ ಕೆಲಸ ಮಾಡಬಹುದು. Agent user request ಅರ್ಥಮಾಡಿಕೊಂಡು RAG ಮೂಲಕ relevant information retrieve ಮಾಡಿ ಆ knowledge ಆಧಾರದಲ್ಲಿ next action ಅಥವಾ response generate ಮಾಡಬಹುದು.
RAG ಯಾವ applicationsಗೆ ಹೆಚ್ಚು useful?
Customer support, internal company assistants, document search, education, research, technical documentation, product support ಮತ್ತು domain-specific AI applicationsಗಳಲ್ಲಿ RAG ವಿಶೇಷವಾಗಿ useful.
Conclusion
AI systems ಇನ್ನಷ್ಟು powerful ಆಗುತ್ತಿದ್ದಂತೆ ಒಂದು ವಿಷಯ ಸ್ಪಷ್ಟವಾಗುತ್ತಿದೆ: intelligence ಮಾತ್ರ ಸಾಕಾಗುವುದಿಲ್ಲ; relevant knowledge access ಕೂಡ ಬೇಕು.
RAG ಈ ಎರಡನ್ನು connect ಮಾಡುತ್ತದೆ.
LLM language ಮತ್ತು reasoning capabilities ನೀಡುತ್ತದೆ.
Retrieval system relevant information ಹುಡುಕುತ್ತದೆ.
Knowledge base domain-specific data ನೀಡುತ್ತದೆ.
ಈ ಮೂರು components ಸರಿಯಾಗಿ work ಮಾಡಿದಾಗ AI ಹೆಚ್ಚು context-aware ಮತ್ತು grounded responses ನೀಡಲು ಸಾಧ್ಯವಾಗುತ್ತದೆ.
ಆದ್ದರಿಂದ RAG ಅನ್ನು ಕೇವಲ ಒಂದು AI buzzword ಎಂದು ನೋಡುವ ಬದಲು, AI models ಅನ್ನು real-world knowledge ಜೊತೆ connect ಮಾಡುವ core architecture ಎಂದು ಅರ್ಥಮಾಡಿಕೊಳ್ಳುವುದು ಹೆಚ್ಚು useful.
AI assistants, enterprise search, customer support ಮತ್ತು AI agents ಮುಂದುವರಿದಂತೆ RAG concepts ತಿಳಿದಿರುವುದು AI users ಮಾತ್ರವಲ್ಲದೆ developers, content creators ಮತ್ತು technology professionalsಗೂ valuable skill ಆಗಬಹುದು.