AI Data Observability ಎಂದರೇನು? AI Systemsನ Data Quality ಮತ್ತು Reliability ಹೇಗೆ ಕಾಪಾಡಬಹುದು?
Introduction
AI systemನ performance ಕೇವಲ ಉತ್ತಮ AI Model ಮೇಲೆ depend ಆಗುವುದಿಲ್ಲ. Modelಗೆ ಹೋಗುವ Data ತಪ್ಪಾಗಿದ್ದರೆ, incomplete ಆಗಿದ್ದರೆ ಅಥವಾ pipelineನಲ್ಲಿ ಎಲ್ಲಾದರೂ ಸಮಸ್ಯೆ ಇದ್ದರೆ, ಉತ್ತಮ Model ಕೂಡ unreliable output ನೀಡಬಹುದು. ಅದಕ್ಕಾಗಿಯೇ AI applications ಬೆಳೆಯುತ್ತಿದ್ದಂತೆ Data ಅನ್ನು continuously observe ಮತ್ತು monitor ಮಾಡುವುದು ಹೆಚ್ಚು ಮುಖ್ಯವಾಗುತ್ತಿದೆ.
ಇಲ್ಲಿ AI Data Observability ಎಂಬ concept ಬರುತ್ತದೆ. ಇದು AI systemಗೆ ಬಳಸಲಾಗುವ Data ಎಲ್ಲಿಂದ ಬರುತ್ತಿದೆ, ಸರಿಯಾಗಿ ಬರುತ್ತಿದೆಯೇ, quality ಹೇಗಿದೆ ಮತ್ತು pipelineನಲ್ಲಿ unexpected changes ಆಗುತ್ತಿವೆಯೇ ಎಂಬುದನ್ನು ಗಮನಿಸಲು ಸಹಾಯ ಮಾಡುವ approach.
ಸರಳವಾಗಿ ಹೇಳುವುದಾದರೆ, AI Data Observability ಎಂದರೆ AI systemಗೆ ಸಂಬಂಧಿಸಿದ Dataನ health ಮತ್ತು reliability ಅನ್ನು continuously ಅರ್ಥಮಾಡಿಕೊಳ್ಳುವ ಮತ್ತು ಸಮಸ್ಯೆಗಳನ್ನು ಬೇಗ ಗುರುತಿಸುವ ವಿಧಾನ.
ಈ articleನಲ್ಲಿ AI Data Observability ಎಂದರೇನು, ಇದು ಸಾಮಾನ್ಯ Data Monitoringಗಿಂತ ಹೇಗೆ ವಿಭಿನ್ನವಾಗಿದೆ, AI systemsಗೆ ಇದು ಯಾಕೆ ಮುಖ್ಯ, Data ಸಮಸ್ಯೆಗಳು AI output ಮೇಲೆ ಹೇಗೆ ಪರಿಣಾಮ ಬೀರುತ್ತವೆ ಮತ್ತು practical workflowನಲ್ಲಿ ಇದನ್ನು ಹೇಗೆ ಬಳಸಬಹುದು ಎಂಬುದನ್ನು beginner-friendly Kannada-English hybrid ಭಾಷೆಯಲ್ಲಿ ನೋಡೋಣ.
Quick Summary
AI Data Observability ಎಂದರೆ AI systemನಲ್ಲಿ ಬಳಸಲಾಗುವ Data ಮತ್ತು Data Pipelinesನ health, quality, consistency ಮತ್ತು unexpected changesಗಳನ್ನು monitor ಮಾಡಲು ಬಳಸುವ approach.
ಒಂದು AI systemನಲ್ಲಿ:
Data Sources → Data Pipeline → Data Processing → Dataset → AI Model → Output
ಎಂಬ flow ಇರಬಹುದು.
ಈ flowನಲ್ಲಿ ಎಲ್ಲಾದರೂ Data ಸಮಸ್ಯೆ ಬಂದರೆ Model output ಕೂಡ ಪರಿಣಾಮಕ್ಕೊಳಗಾಗಬಹುದು.
AI Data Observability ಮೂಲಕ ಸಾಮಾನ್ಯವಾಗಿ ಗಮನಿಸಬಹುದಾದ ವಿಷಯಗಳು:
- Data quality
- Missing data
- Duplicate records
- Unexpected data changes
- Data freshness
- Schema changes
- Pipeline failures
- Data volume changes
- Distribution changes
- Modelಗೆ ಹೋಗುವ inputನಲ್ಲಿ anomalies
ಇದರ ಮುಖ್ಯ ಉದ್ದೇಶ ಕೇವಲ “Data ಇದೆ” ಎಂದು ನೋಡುವುದಲ್ಲ. “AI systemಗೆ ಹೋಗುತ್ತಿರುವ Dataನಲ್ಲಿ ಏನಾದರೂ unusual ಆಗಿ ಬದಲಾಗಿದೆಯೇ?” ಎಂಬುದನ್ನು ಬೇಗ ಗುರುತಿಸುವುದು.
AI Data Observability ಎಂದರೇನು?
ಒಂದು AI system ಅನ್ನು ಒಂದು ದೊಡ್ಡ machine ಎಂದು ಕಲ್ಪಿಸಿಕೊಳ್ಳಿ. ಆ machine ಒಳಗೆ AI Model ಮಾತ್ರ ಇರುವುದಿಲ್ಲ. ಅದಕ್ಕೆ Data ಬೇಕು, Data Pipeline ಬೇಕು, databases ಇರಬಹುದು, APIs ಇರಬಹುದು, processing systems ಇರಬಹುದು ಮತ್ತು ಕೊನೆಯಲ್ಲಿ userಗೆ output ನೀಡುವ application ಇರಬಹುದು.
ಈ ಸಂಪೂರ್ಣ systemನಲ್ಲಿ Data ಒಂದು ಪ್ರಮುಖ raw material.
ಒಂದು simple example ನೋಡೋಣ.
ನೀವು e-commerce websiteಗಾಗಿ recommendation system ನಿರ್ಮಿಸಿದ್ದೀರಿ ಎಂದುಕೊಳ್ಳಿ. User ಯಾವ products ನೋಡುತ್ತಾರೆ, ಯಾವ products ಖರೀದಿಸುತ್ತಾರೆ, ಯಾವ category ಹೆಚ್ಚು search ಮಾಡುತ್ತಾರೆ ಮುಂತಾದ Data systemಗೆ ಬರುತ್ತಿರುತ್ತದೆ.
ಈ Dataನಲ್ಲಿ ಇದ್ದಕ್ಕಿದ್ದಂತೆ ಸಮಸ್ಯೆ ಬಂದರೆ ಏನಾಗಬಹುದು?
- ಕೆಲವು records missing ಆಗಬಹುದು.
- ಕೆಲವು values
nullಆಗಬಹುದು. - ಒಂದು fieldನ format ಬದಲಾಗಬಹುದು.
- Data ಮೂರು ದಿನ ಹಳೆಯದಾಗಿರಬಹುದು.
- ಒಂದೇ record ಹಲವು ಬಾರಿ ಬರಬಹುದು.
- ಒಂದು sourceನಿಂದ Data ಬರದೇ ಹೋಗಬಹುದು.
AI Model ತನ್ನ ಕೆಲಸ ಮಾಡುತ್ತಲೇ ಇರಬಹುದು. Pipeline ಕೂಡ “running” ಎಂದು ತೋರಿಸಬಹುದು. ಆದರೆ Modelಗೆ ಹೋಗುತ್ತಿರುವ Data ತಪ್ಪಾಗಿದ್ದರೆ output quality ಮೇಲೆ ಪರಿಣಾಮ ಬೀಳಬಹುದು.
ಇಂತಹ Data-related problems ಅನ್ನು ಮುಂಚಿತವಾಗಿ ಗುರುತಿಸಲು, investigate ಮಾಡಲು ಮತ್ತು Data systemನ health ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ಬಳಸುವ approach ಅನ್ನು Data Observability ಎಂದು ಕರೆಯಬಹುದು.
AI applicationsನ contextನಲ್ಲಿ ಇದನ್ನೇ AI Data Observability ಎಂದು ಅರ್ಥಮಾಡಿಕೊಳ್ಳಬಹುದು.
ಸರಳವಾಗಿ:
AI Data Observability ಎಂದರೆ AI systemಗೆ ಹೋಗುತ್ತಿರುವ Data ಸರಿಯಾಗಿ, ಸಮಯಕ್ಕೆ, expected structureನಲ್ಲಿ ಮತ್ತು reasonable qualityಯೊಂದಿಗೆ ಬರುತ್ತಿದೆಯೇ ಎಂಬುದನ್ನು continuously ಗಮನಿಸುವುದು.
ಇಲ್ಲಿ “observe” ಎಂದರೆ ಕೇವಲ Data ನೋಡುತ್ತಾ ಕುಳಿತುಕೊಳ್ಳುವುದು ಅಲ್ಲ.
Systemನಲ್ಲಿ unusual change ಬಂದಾಗ:
ಏನು ಬದಲಾಗಿದೆ? → ಎಲ್ಲಿ ಬದಲಾಗಿದೆ? → ಯಾವ Dataಗೆ ಪರಿಣಾಮ ಬಿದ್ದಿದೆ? → AI system ಮೇಲೆ ಪರಿಣಾಮ ಏನು?
ಎಂಬ ಪ್ರಶ್ನೆಗಳಿಗೆ ಉತ್ತರ ಹುಡುಕಲು ಸಹಾಯ ಮಾಡುವ visibility ಮುಖ್ಯ.
→ AWS Glue Data Quality — Official Documentation
AI Data Observability ಯಾಕೆ ಮುಖ್ಯ?
AI Model ಎಷ್ಟು sophisticated ಆಗಿದ್ದರೂ, ಅದಕ್ಕೆ ಹೋಗುವ Dataನಲ್ಲಿ ಸಮಸ್ಯೆ ಇದ್ದರೆ result ಮೇಲೆ ಪರಿಣಾಮ ಬೀಳಬಹುದು.
ಇದನ್ನು ಒಂದು simple analogy ಮೂಲಕ ಅರ್ಥಮಾಡಿಕೊಳ್ಳಬಹುದು.
ಒಂದು ಕಾರಿಗೆ ತುಂಬಾ powerful engine ಇದೆ ಎಂದುಕೊಳ್ಳಿ. ಆದರೆ fuel contaminated ಆಗಿದ್ದರೆ engineನ performance ಮೇಲೆ ಪರಿಣಾಮ ಬೀಳಬಹುದು.
AI systemನಲ್ಲಿ:
AI Model = Engine
Data = Fuel
ಎಂದು ಸರಳವಾಗಿ imagine ಮಾಡಬಹುದು.
ಇದು exact technical equivalence ಅಲ್ಲ, ಆದರೆ beginnerಗೆ concept ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು useful analogy.
ಒಂದು Real-World Example
ಒಂದು companyಗೆ customer support AI system ಇದೆ.
ಅದು customer history Data ಬಳಸುತ್ತದೆ.
ಒಂದು ದಿನ Data pipelineನಲ್ಲಿ ಒಂದು field:
customer_type
ಹಿಂದೆ:
newexisting
ಎಂದು ಬರುತ್ತಿತ್ತು.
ಆದರೆ ಹೊಸ software update ನಂತರ values:
NE
ಎಂದು ಬದಲಾಗುತ್ತವೆ.
Pipeline technically running ಆಗಿರಬಹುದು. Database ಕೂಡ data receive ಮಾಡುತ್ತಿರಬಹುದು.
ಆದರೆ downstream systemಗೆ expected format ಬದಲಾಗಿದೆ.
ಇದು ಒಂದು Data Quality / Schema-related issue ಆಗಬಹುದು.
Observability ಇಲ್ಲದಿದ್ದರೆ problem ತಕ್ಷಣ ಗಮನಕ್ಕೆ ಬರದೇ ಇರಬಹುದು.
Observability ಇದ್ದರೆ unexpected change ಬಗ್ಗೆ alert ಅಥವಾ investigation trigger ಆಗಬಹುದು.
ಇದರಿಂದ team:
“AI Model ತಪ್ಪು ಮಾಡುತ್ತಿದೆ”
ಎಂದು Modelನನ್ನೇ blame ಮಾಡುವ ಬದಲು, ಮೊದಲು:
“Modelಗೆ ಹೋಗುತ್ತಿರುವ Dataನಲ್ಲಿ ಏನಾದರೂ ಬದಲಾಗಿದೆಯೇ?”
ಎಂದು ಪರಿಶೀಲಿಸಬಹುದು.
→ OpenTelemetry — Observability Primer
AI Data Observability ಹೇಗೆ ಕೆಲಸ ಮಾಡುತ್ತದೆ?
AI Data Observabilityಯನ್ನು ಒಂದು single dashboard ಎಂದು ಮಾತ್ರ ಅರ್ಥಮಾಡಿಕೊಳ್ಳಬಾರದು.
ಇದು ಸಾಮಾನ್ಯವಾಗಿ Data ecosystemನ ಹಲವು ಭಾಗಗಳನ್ನು observe ಮಾಡುವ ಒಂದು broader approach.
ಒಂದು basic workflow ಹೀಗಿರಬಹುದು:
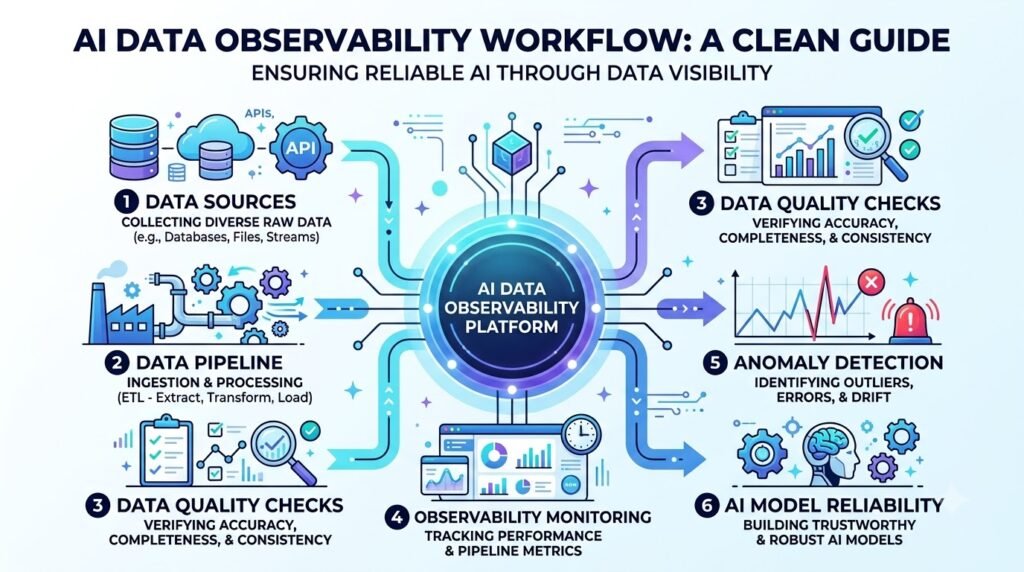
Data Sources → Data Pipeline → Data Quality Checks → Observability → Anomaly Detection → Investigation → AI System
ಈ flowನ ಪ್ರತಿಯೊಂದು ಹಂತವನ್ನು ಸರಳವಾಗಿ ನೋಡೋಣ.
1. Data Sources
ಮೊದಲು Data ಎಲ್ಲಿಂದ ಬರುತ್ತಿದೆ ಎಂಬುದನ್ನು ಗುರುತಿಸಬೇಕು.
Data source ಆಗಿ:
- Database
- Website
- Mobile App
- API
- Sensor
- CRM
- Transaction System
- External Dataset
ಇರಬಹುದು.
AI application ಯಾವ sourceಗಳಿಂದ Data ಪಡೆಯುತ್ತಿದೆ ಎಂಬ visibility ಇದ್ದರೆ ಸಮಸ್ಯೆ ಬಂದಾಗ investigation ಸುಲಭವಾಗುತ್ತದೆ.
2. Data Pipeline
Data sourceನಿಂದ Data ನೇರವಾಗಿ AI Modelಗೆ ಹೋಗುವುದಿಲ್ಲ.
ಸಾಮಾನ್ಯವಾಗಿ ಮಧ್ಯದಲ್ಲಿ ಹಲವು processing steps ಇರಬಹುದು.
ಉದಾಹರಣೆಗೆ:
Database → Extraction → Cleaning → Transformation → Feature/Data Store → AI Model
ಇದನ್ನೇ broadly Data Pipeline ಎಂದು ಕರೆಯಬಹುದು.
Pipelineನಲ್ಲಿ ಒಂದು step fail ಆದರೆ downstreamಗೆ Data incomplete ಆಗಬಹುದು.
ಉದಾಹರಣೆಗೆ ರಾತ್ರಿ 2 ಗಂಟೆಗೆ ನಡೆಯಬೇಕಿದ್ದ Data ingestion job fail ಆಯಿತು ಎಂದುಕೊಳ್ಳಿ.
ಮುಂದಿನ ಬೆಳಗ್ಗೆ AI applicationಗೆ ಹೊಸ Data ಸಿಗದೇ ಇರಬಹುದು.
Application technically online ಇದ್ದರೂ Data stale ಆಗಿರಬಹುದು.
ಇದನ್ನು ಬೇಗ ಗುರುತಿಸುವುದು Observabilityಯ ಒಂದು important purpose.
3. Data Quality Checks
Data systemನಲ್ಲಿ ಕೆಲವು basic quality questions ಕೇಳಬಹುದು.
ಉದಾಹರಣೆಗೆ:
- Expected columns ಇವೆಯೇ?
- Required values missing ಆಗಿವೆಯೇ?
- Duplicate records ಹೆಚ್ಚಾಗಿದೆಯೇ?
- Data type ಬದಲಾಗಿದೆಯೇ?
- Values expected rangeನಲ್ಲಿ ಇವೆಯೇ?
- Data volume ಸಾಮಾನ್ಯಕ್ಕಿಂತ ತುಂಬಾ ಕಡಿಮೆಯಾಗಿದೆಯೇ?
- Data ಸಮಯಕ್ಕೆ update ಆಗಿದೆಯೇ?
ಇವುಗಳೆಲ್ಲ Data health ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ಸಹಾಯ ಮಾಡಬಹುದು.
4. Monitoring
Data continuously ಬರುತ್ತಿರುವುದರಿಂದ ಒಂದು ಬಾರಿ check ಮಾಡಿದರೆ ಸಾಕಾಗುವುದಿಲ್ಲ.
ಇಂದು Data correct ಇದ್ದರೂ ನಾಳೆ pipeline change ಆಗಬಹುದು.
ಅದಕ್ಕಾಗಿ monitoring ಮೂಲಕ:
Normal behaviour → New data → Compare → Detect unusual change
ಎಂಬ ರೀತಿಯ process ಇರಬಹುದು.
ಇಲ್ಲಿ “normal” ಎಂದರೆ ಹಿಂದಿನ Data behaviour ಅಥವಾ predefined expectations ಆಧರಿಸಿದ baseline ಆಗಿರಬಹುದು.
5. Anomaly Detection
Dataನಲ್ಲಿ expected patternಗೆ ವಿರುದ್ಧವಾದ change ಕಂಡುಬಂದರೆ ಅದನ್ನು anomaly ಎಂದು ಪರಿಗಣಿಸಬಹುದು.
ಉದಾಹರಣೆಗೆ:
ಸಾಮಾನ್ಯವಾಗಿ ಒಂದು ದಿನಕ್ಕೆ 1 ಲಕ್ಷ records ಬರುತ್ತವೆ.
ಒಂದು ದಿನ ಕೇವಲ 5,000 records ಬಂದರೆ ಅದು investigationಗೆ ಕಾರಣವಾಗಬಹುದು.
ಅದೇ ರೀತಿ ಸಾಮಾನ್ಯವಾಗಿ 2% missing values ಇದ್ದು, ಒಂದು ದಿನ 40% ಆಗಿದ್ದರೆ ಅದು unusual change.
ಆದರೆ ಪ್ರತಿಯೊಂದು unusual change ಕೂಡ error ಎಂದೇ ಅರ್ಥವಲ್ಲ.
ಕೆಲವೊಮ್ಮೆ business event ಕಾರಣವಾಗಿರಬಹುದು.
ಉದಾಹರಣೆಗೆ:
- Festival season
- Product launch
- Sale event
- Website traffic spike
ಇವು Data volume ಬದಲಾಯಿಸಬಹುದು.
ಆದ್ದರಿಂದ anomaly ಕಂಡುಬಂದ ನಂತರ context ಜೊತೆಗೆ investigate ಮಾಡುವುದು ಮುಖ್ಯ.
Data Qualityನಲ್ಲಿ ಯಾವ ವಿಷಯಗಳನ್ನು ಗಮನಿಸಬೇಕು?
AI systemನ Data quality ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ಒಂದೇ metric ಸಾಕಾಗುವುದಿಲ್ಲ.
ಹಲವು dimensions ಗಮನಿಸಬೇಕಾಗಬಹುದು.
Data Freshness
Data ಎಷ್ಟು recent ಆಗಿದೆ ಎಂಬುದನ್ನು freshness ಎಂದು ಅರ್ಥಮಾಡಿಕೊಳ್ಳಬಹುದು.
ಉದಾಹರಣೆಗೆ ಒಂದು news recommendation systemಗೆ ಪ್ರತಿದಿನ update ಆಗಬೇಕಾದ Data ಐದು ದಿನ ಹಳೆಯದಾಗಿದ್ದರೆ, Data technically available ಇದ್ದರೂ applicationಗೆ ಅದು useful ಆಗದೇ ಇರಬಹುದು.
Data Completeness
Expected Data ಎಷ್ಟು ಪ್ರಮಾಣದಲ್ಲಿ available ಇದೆ ಎಂಬುದು ಇಲ್ಲಿ ಮುಖ್ಯ.
ಉದಾಹರಣೆಗೆ 1 ಲಕ್ಷ records ಬರಬೇಕಾದಾಗ ಕೇವಲ 60,000 records ಬಂದರೆ completeness problem ಇರಬಹುದು.
Data Consistency
ಒಂದೇ information ಬೇರೆ systemsನಲ್ಲಿ ಬೇರೆ ರೀತಿಯಲ್ಲಿ ಇದ್ದರೆ consistency issue ಉಂಟಾಗಬಹುದು.
ಉದಾಹರಣೆಗೆ ಒಂದು systemನಲ್ಲಿ:
Karnataka
ಇನ್ನೊಂದರಲ್ಲಿ:
KA
ಮತ್ತು ಮತ್ತೊಂದು systemನಲ್ಲಿ:
Karnataka State
ಎಂದು represent ಮಾಡಿದರೆ downstream processingಗೆ additional logic ಬೇಕಾಗಬಹುದು.
Data Validity
Data expected format ಅಥವಾ allowed valuesಗೆ ಹೊಂದಿಕೆಯಾಗುತ್ತಿದೆಯೇ ಎಂಬುದನ್ನು ನೋಡಬೇಕು.
ಉದಾಹರಣೆಗೆ age fieldನಲ್ಲಿ:
25
ಸರಿಯಾದ value ಆಗಿರಬಹುದು.
ಆದರೆ:
-500
ಬಂದರೆ validity issue ಇರಬಹುದು.
Data Volume
ಒಂದು pipelineನಲ್ಲಿ ಸಾಮಾನ್ಯವಾಗಿ ಬರುತ್ತಿರುವ Data ಪ್ರಮಾಣದಲ್ಲಿ sudden change ಆಗಿದೆಯೇ ಎಂಬುದನ್ನೂ ಗಮನಿಸಬಹುದು.
Volume ತುಂಬಾ ಕಡಿಮೆಯಾದರೆ ingestion problem ಇರಬಹುದು.
Volume ಅಸಾಮಾನ್ಯವಾಗಿ ಹೆಚ್ಚಾದರೆ duplicate records ಅಥವಾ upstream issue ಇರಬಹುದು.
→ Google Cloud — Use Auto Data Quality
AI Modelಗೆ Data Problem ಹೇಗೆ ಪರಿಣಾಮ ಬೀರುತ್ತದೆ?
ಇಲ್ಲಿ ಒಂದು important concept ಇದೆ.
Data problem ಯಾವಾಗಲೂ Model error ಆಗಿ ಕಾಣಿಸಿಕೊಳ್ಳುವುದಿಲ್ಲ.
ಕೆಲವೊಮ್ಮೆ Model technically correct ಆಗಿ run ಆಗುತ್ತದೆ.
ಆದರೆ input Data ಬದಲಾಗಿರುವುದರಿಂದ output behaviour ಬದಲಾಗಬಹುದು.
ಉದಾಹರಣೆಗೆ ಒಂದು recommendation Model user behaviour Data ಬಳಸುತ್ತದೆ.
ಹಿಂದೆ:
Mobile users = 70%
ಆದರೆ Data collection issue ಕಾರಣದಿಂದ ಒಂದು ವಾರ:
Mobile users = 20%
ಎಂದು record ಆಗುತ್ತಿದೆ.
Modelಗೆ Data ಸಿಗುತ್ತಿದೆ.
Model crash ಆಗುವುದಿಲ್ಲ.
ಆದರೆ Data reality ಅನ್ನು represent ಮಾಡುತ್ತಿಲ್ಲ.
ಇಂತಹ ಸಂದರ್ಭದಲ್ಲಿ output quality ಮೇಲೆ ಪರಿಣಾಮ ಬೀರುವ ಸಾಧ್ಯತೆ ಇದೆ.
ಅದಕ್ಕಾಗಿಯೇ:
Model Monitoring ಮಾತ್ರವಲ್ಲ, Data Monitoring ಕೂಡ ಮುಖ್ಯ.
ಇವೆರಡೂ ಒಂದೇ ಅಲ್ಲ.
Data Observability ಮತ್ತು Model Monitoring ನಡುವಿನ ವ್ಯತ್ಯಾಸ
ಈ ಎರಡು concepts ಅನ್ನು beginners ಹೆಚ್ಚಾಗಿ confuse ಮಾಡಬಹುದು.
Data Observability ಮುಖ್ಯವಾಗಿ Data ಮತ್ತು Data Pipelineನ health ಬಗ್ಗೆ ಗಮನ ಕೊಡುತ್ತದೆ.
Model Monitoring Modelನ behaviour ಮತ್ತು performance ಬಗ್ಗೆ ಗಮನ ಕೊಡುತ್ತದೆ.
| Data Observability | Model Monitoring |
|---|---|
| Data quality ನೋಡುತ್ತದೆ | Model behaviour ನೋಡುತ್ತದೆ |
| Pipeline health ಗಮನಿಸುತ್ತದೆ | Predictions ಮತ್ತು performance ಗಮನಿಸಬಹುದು |
| Missing Data detect ಮಾಡಬಹುದು | Prediction changes detect ಮಾಡಬಹುದು |
| Schema changes ಗಮನಿಸಬಹುದು | Model drift ಮುಂತಾದ ವಿಷಯಗಳನ್ನು monitor ಮಾಡಬಹುದು |
| Data freshness ನೋಡಬಹುದು | Model output quality metrics ನೋಡಬಹುದು |
ಒಂದು AI system reliable ಆಗಿರಬೇಕಾದರೆ ಎರಡೂ layers relevant ಆಗಬಹುದು.
ಸರಳವಾಗಿ:
Data ಸರಿಯಾಗಿದೆಯೇ? → Data Observability
Model ಸರಿಯಾಗಿ behave ಮಾಡುತ್ತಿದೆಯೇ? → Model Monitoring
ಆದರೆ practical systemsನಲ್ಲಿ ಇವೆರಡರ boundaries tool ಮತ್ತು architecture ಆಧರಿಸಿ ಬದಲಾಗಬಹುದು.
AI Data Observability ಮತ್ತು Data Monitoring ಒಂದೇನಾ?
ಹಲವು ಸಂದರ್ಭಗಳಲ್ಲಿ ಈ terms ಹತ್ತಿರದ ಅರ್ಥದಲ್ಲಿ ಬಳಸಲ್ಪಡಬಹುದು. ಆದರೆ Observability ಸಾಮಾನ್ಯವಾಗಿ simple “metric ನೋಡಿ” monitoringಗಿಂತ broader visibilityಯನ್ನು ಸೂಚಿಸುತ್ತದೆ.
Monitoring ನಮಗೆ:
“ಒಂದು metric threshold ಮೀರಿದೆ.”
ಎಂದು ಹೇಳಬಹುದು.
Observability approachನಲ್ಲಿ:
“ಯಾವ Data ಬದಲಾಗಿದೆ? ಯಾವ pipeline affected? ಯಾವ downstream table ಮೇಲೆ ಪರಿಣಾಮ ಬಿದ್ದಿದೆ? ಈ change ಯಾವ ಸಮಯದಲ್ಲಿ ಆರಂಭವಾಯಿತು?”
ಎಂಬ investigationಗೆ ಸಹಾಯ ಮಾಡುವ context ಕೂಡ ಮುಖ್ಯವಾಗುತ್ತದೆ.
ಅಂದರೆ:
Monitoring → ಸಮಸ್ಯೆ ಇದೆ ಎಂದು ತಿಳಿಯುವುದು
Observability → ಸಮಸ್ಯೆಯನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ಬೇಕಾದ visibility ಪಡೆಯುವುದು
ಎಂಬ ಸರಳ distinction beginnerಗೆ useful.
ಒಂದು Practical AI Data Observability Workflow
ಒಂದು small businessಗೆ customer analytics AI system ಇದೆ ಎಂದುಕೊಳ್ಳೋಣ.
ಪ್ರತಿದಿನ customer transactions Data pipeline ಮೂಲಕ AI analytics systemಗೆ ಹೋಗುತ್ತದೆ.
ಒಂದು ದಿನ reportನಲ್ಲಿ strange results ಕಾಣಿಸುತ್ತವೆ.
Step 1: Problem Notice
Dashboardನಲ್ಲಿ transaction count ಸಾಮಾನ್ಯಕ್ಕಿಂತ ಕಡಿಮೆಯಾಗಿದೆ.
Step 2: Data Check
Observability system Data volume ಕಡಿಮೆಯಾಗಿದೆ ಎಂದು ತೋರಿಸುತ್ತದೆ.
Step 3: Pipeline Investigation
Team pipeline logs ಪರಿಶೀಲಿಸುತ್ತದೆ.
ಒಂದು ingestion job fail ಆಗಿರುವುದು ಕಂಡುಬರುತ್ತದೆ.
Step 4: Root Cause
API authentication token expire ಆಗಿರುವುದು ಗೊತ್ತಾಗುತ್ತದೆ.
Step 5: Fix
Authentication issue ಸರಿಪಡಿಸಿ pipeline ಮತ್ತೆ run ಮಾಡಲಾಗುತ್ತದೆ.
Step 6: Validation
ಹೊಸ Data expected volumeನಲ್ಲಿ ಬರುತ್ತಿದೆಯೇ ಎಂದು check ಮಾಡಲಾಗುತ್ತದೆ.
Step 7: AI System Check
AI applicationನಲ್ಲಿ output ಮತ್ತೆ normal ಆಗಿದೆಯೇ ಎಂದು ಪರಿಶೀಲಿಸಲಾಗುತ್ತದೆ.
ಇಲ್ಲಿ Observabilityಯ value ಸ್ಪಷ್ಟವಾಗುತ್ತದೆ.
Problem ಕಾಣಿಸಿಕೊಳ್ಳುವುದರಿಂದ Root Cause ಕಂಡುಹಿಡಿಯುವವರೆಗೆ visibility ಸಿಗುತ್ತದೆ.
AI Data Observability ಯಾರು ಬಳಸುತ್ತಾರೆ?
ಇದು ಕೇವಲ ದೊಡ್ಡ AI companiesಗೆ ಮಾತ್ರ ಸೀಮಿತವಾದ concept ಅಲ್ಲ.
Data Engineers
Data Engineersಗೆ pipelines, ingestion jobs ಮತ್ತು transformations reliable ಆಗಿವೆಯೇ ಎಂಬುದನ್ನು monitor ಮಾಡಲು ಸಹಾಯ ಮಾಡಬಹುದು.
ML Engineers
ML Engineersಗೆ Modelಗೆ ಹೋಗುತ್ತಿರುವ input Dataನಲ್ಲಿ unexpected changes ಇದೆಯೇ ಎಂದು ಗಮನಿಸಲು ಉಪಯುಕ್ತವಾಗಬಹುದು.
AI Platform Teams
ದೊಡ್ಡ AI infrastructureನಲ್ಲಿ ಹಲವು Data sources ಮತ್ತು services ಇದ್ದಾಗ overall Data health ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು observability ಮುಖ್ಯವಾಗಬಹುದು.
Businesses
Business usersಗೆ technical pipeline details ಗೊತ್ತಿರದಿದ್ದರೂ, Data ಸಮಸ್ಯೆಯಿಂದ reports ಅಥವಾ AI-powered applications ಮೇಲೆ ಪರಿಣಾಮ ಬೀಳುತ್ತಿದೆಯೇ ಎಂಬುದು ಮುಖ್ಯ.
ಹೀಗಾಗಿ AI Data Observability ಒಂದು technical engineering concept ಆಗಿದ್ದರೂ, ಅದರ ಪರಿಣಾಮ business decisionsವರೆಗೂ ಹೋಗಬಹುದು.
AI Data Observabilityನ Practical Benefits
AI systemನಲ್ಲಿ Data ಸರಿಯಾಗಿ ಕೆಲಸ ಮಾಡುತ್ತಿದೆಯೇ ಎಂಬುದನ್ನು ಕೇವಲ Model output ನೋಡಿ ತಿಳಿದುಕೊಳ್ಳುವುದು ಯಾವಾಗಲೂ ಸಾಧ್ಯವಿಲ್ಲ. ಕೆಲವೊಮ್ಮೆ Model error ತೋರಿಸದೇ ಇದ್ದರೂ, Data ಒಳಗೆ ಆಗಿರುವ ಸಣ್ಣ ಬದಲಾವಣೆಗಳು output quality ಮೇಲೆ ಪರಿಣಾಮ ಬೀರುತ್ತಿರಬಹುದು.
ಇಲ್ಲಿ AI Data Observability practical ಆಗಿ ಸಹಾಯ ಮಾಡುತ್ತದೆ.
1. Data ಸಮಸ್ಯೆಗಳನ್ನು ಬೇಗ ಗುರುತಿಸಬಹುದು
ಒಂದು Data pipeline ಪ್ರತಿದಿನ ಬೆಳಗ್ಗೆ 8 ಗಂಟೆಗೆ ಹೊಸ Data ತರಬೇಕು ಎಂದುಕೊಳ್ಳಿ. ಆದರೆ ಯಾವುದೋ ಕಾರಣದಿಂದ Data 8 ಗಂಟೆಗೆ ಬರುವ ಬದಲು 11 ಗಂಟೆಗೆ ಬರುತ್ತಿದೆ.
System ಸಂಪೂರ್ಣವಾಗಿ crash ಆಗಿಲ್ಲ. ಆದರೆ downstream AI workflowಗೆ Data late ಆಗುತ್ತದೆ.
AI Data Observability ಮೂಲಕ ಇಂತಹ Data Freshness ಸಮಸ್ಯೆಯನ್ನು ಗಮನಿಸಬಹುದು.
2. Data Quality ಬಗ್ಗೆ visibility ಸಿಗುತ್ತದೆ
Dataನಲ್ಲಿ:
- Missing values
- Duplicate records
- Invalid values
- Unexpected formats
- Schema changes
- Sudden volume changes
ಇಂತಹ ಸಮಸ್ಯೆಗಳು ಬಂದಾಗ ಅವುಗಳನ್ನು identify ಮಾಡಲು observability ಸಹಾಯ ಮಾಡುತ್ತದೆ.
ಅಂದರೆ “Data ಇದೆ” ಎನ್ನುವುದಷ್ಟೇ ಸಾಕಾಗುವುದಿಲ್ಲ. “Data ಸರಿಯಾಗಿದೆಯೇ?” ಎನ್ನುವುದನ್ನೂ ಗಮನಿಸಬೇಕು.
3. Root Cause ಹುಡುಕಲು ಸುಲಭವಾಗುತ್ತದೆ
ಒಂದು AI applicationನ output ಏಕಾಏಕಿ ಬದಲಾಗಿದೆ ಎಂದುಕೊಳ್ಳಿ.
Model ಬದಲಾಗಿಲ್ಲ. ಆದರೆ output ಬದಲಾಗಿದೆ.
ಆಗ ಪ್ರಶ್ನೆಗಳು ಬರುತ್ತವೆ:
ಯಾವ Data ಬದಲಾಗಿದೆ?
ಯಾವ Pipelineನಲ್ಲಿ ಬದಲಾವಣೆ ಆಯಿತು?
ಯಾವ ಸಮಯದಿಂದ ಸಮಸ್ಯೆ ಶುರುವಾಯಿತು?
ಯಾವ Datasetಗೆ ಪರಿಣಾಮವಾಗಿದೆ?
AI Data Observability ಈ investigationಗೆ ಬೇಕಾದ visibility ನೀಡಬಹುದು.
4. AI System Reliability ಸುಧಾರಿಸಬಹುದು
ಒಂದು reliable AI system ಎಂದರೆ ಕೇವಲ powerful Model ಹೊಂದಿರುವ system ಅಲ್ಲ.
ಅದರ Data ಕೂಡ:
Fresh + Complete + Consistent + Valid + Traceable
ಆಗಿರಬೇಕು.
ಆದ್ದರಿಂದ Data Observability, ಒಟ್ಟಾರೆ AI Reliabilityನಲ್ಲಿ ಒಂದು ಪ್ರಮುಖ ಭಾಗವಾಗಬಹುದು.
AI Systemsನಲ್ಲಿ Common Data Problems
AI systemನಲ್ಲಿ Data ಸಮಸ್ಯೆಗಳು ಹಲವು ರೀತಿಯಲ್ಲಿ ಕಾಣಿಸಿಕೊಳ್ಳಬಹುದು. ಅವುಗಳಲ್ಲಿ ಕೆಲವು ಹೊರಗಿನಿಂದ ನೋಡಿದಾಗ ಬಹಳ ಸಣ್ಣ ಸಮಸ್ಯೆಗಳಂತೆ ಕಾಣಬಹುದು. ಆದರೆ downstreamನಲ್ಲಿ ದೊಡ್ಡ ಪರಿಣಾಮ ಉಂಟುಮಾಡಬಹುದು.
Missing Data
ಕೆಲವು recordsನಲ್ಲಿ required field ಖಾಲಿಯಾಗಿದ್ದರೆ AI Modelಗೆ incomplete information ಹೋಗಬಹುದು.
ಉದಾಹರಣೆಗೆ customer datasetನಲ್ಲಿ age, location ಅಥವಾ purchase_history fieldsನಲ್ಲಿ ಹೆಚ್ಚಿನ values missing ಆಗಿದ್ದರೆ analysis quality ಮೇಲೆ ಪರಿಣಾಮ ಬೀರುವ ಸಾಧ್ಯತೆ ಇದೆ.
Duplicate Data
ಒಂದೇ customer record ಹಲವು ಬಾರಿ datasetನಲ್ಲಿ ಬಂದರೆ total customer count ತಪ್ಪಾಗಬಹುದು.
ಅದರ ಪರಿಣಾಮ:
Data → Analysis → AI Output
ಎಲ್ಲದರ ಮೇಲೂ ಪರಿಣಾಮ ಬೀರುವ ಸಾಧ್ಯತೆ ಇದೆ.
Stale Data
Data ತುಂಬಾ ಹಳೆಯದಾಗಿದ್ದರೆ ಅದು current situation ಅನ್ನು represent ಮಾಡದೇ ಇರಬಹುದು.
ಉದಾಹರಣೆಗೆ recommendation systemಗೆ ಹಲವು ದಿನಗಳ ಹಿಂದಿನ user activity ಮಾತ್ರ ಸಿಗುತ್ತಿದ್ದರೆ, user’s current interest ಸರಿಯಾಗಿ reflect ಆಗದಿರಬಹುದು.
Schema Change
ಇದು Data pipelineಗಳಲ್ಲಿ ಬಹಳ ಮುಖ್ಯವಾದ ಸಮಸ್ಯೆ.
ಮೊದಲು:
customer_id | customer_type | purchase
ಇತ್ತು ಎಂದುಕೊಳ್ಳಿ.
customer_typeನಲ್ಲಿ new ಮತ್ತು existing values ಬರುತ್ತಿದ್ದವು.
ನಂತರ upstream system ಅದನ್ನು N ಮತ್ತು E ಎಂದು ಬದಲಾಯಿಸಿತು.
Pipeline technically run ಆಗಬಹುದು. ಆದರೆ downstream system ಹಿಂದಿನ format ನಿರೀಕ್ಷಿಸುತ್ತಿದ್ದರೆ ಸಮಸ್ಯೆ ಉಂಟಾಗಬಹುದು.
Data Volumeನಲ್ಲಿ Unexpected Change
ಪ್ರತಿದಿನ ಸುಮಾರು 10 ಲಕ್ಷ records ಬರುತ್ತಿದ್ದವು ಎಂದುಕೊಳ್ಳಿ.
ಒಂದು ದಿನ ಅದು 10 ಲಕ್ಷದಿಂದ 50,000ಕ್ಕೆ ಇಳಿದರೆ, system crash ಆಗದಿದ್ದರೂ Data collectionನಲ್ಲಿ ಸಮಸ್ಯೆ ಇರಬಹುದು.
ಅದೇ ರೀತಿ ಸಾಮಾನ್ಯವಾಗಿ 10 ಲಕ್ಷ records ಬರುತ್ತಿದ್ದಾಗ ಏಕಾಏಕಿ 5 ಕೋಟಿ records ಬಂದರೂ investigation ಬೇಕಾಗಬಹುದು.
ಇಂತಹ unusual changesಗಳನ್ನು ಗಮನಿಸುವುದು Data Observabilityಯ ಪ್ರಮುಖ ಉಪಯೋಗಗಳಲ್ಲಿ ಒಂದು.
AI Data Observability Implement ಮಾಡಲು Basic Workflow
AI Data Observability implement ಮಾಡುವುದು ಎಂದರೆ ತಕ್ಷಣ ದೊಡ್ಡ platform ಖರೀದಿಸಬೇಕು ಎಂದಲ್ಲ.
ಮೊದಲು ನಿಮ್ಮ AI systemನಲ್ಲಿ ಯಾವ Data ಬರುತ್ತಿದೆ, ಅದು ಎಲ್ಲಿ process ಆಗುತ್ತಿದೆ ಮತ್ತು ಯಾವ outputಗೆ ಬಳಸಲಾಗುತ್ತಿದೆ ಎಂಬುದನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳುವುದು ಮುಖ್ಯ.
ಒಂದು basic workflow ಹೀಗೆ ಇರಬಹುದು:
Step 1: Data Sources ಗುರುತಿಸಿ
ಮೊದಲು Data ಎಲ್ಲಿಂದ ಬರುತ್ತಿದೆ ಎಂದು ಪಟ್ಟಿ ಮಾಡಿ.
ಉದಾಹರಣೆಗೆ:
- Database
- API
- CSV files
- Cloud storage
- Application logs
- User-generated Data
- External Data sources
Data source ಗೊತ್ತಿಲ್ಲದೆ Data problem trace ಮಾಡುವುದು ಕಷ್ಟ.
Step 2: Data Pipeline Map ಮಾಡಿ
Data sourceನಿಂದ AI Modelವರೆಗೆ Data ಹೇಗೆ ಪ್ರಯಾಣಿಸುತ್ತದೆ ಎಂಬುದನ್ನು map ಮಾಡಿ.
ಉದಾಹರಣೆಗೆ:
API → Database → ETL Pipeline → Data Warehouse → Dataset → AI Model
ಈ flow ಸ್ಪಷ್ಟವಾಗಿದ್ದರೆ problem ಬಂದಾಗ ಯಾವ stageನಲ್ಲಿ investigate ಮಾಡಬೇಕು ಎನ್ನುವುದು ಸುಲಭವಾಗುತ್ತದೆ.
Step 3: Important Data Quality Checks ಇಡಿ
ಪ್ರತಿ Data fieldಗೆ ಒಂದೇ ರೀತಿಯ check ಬೇಕಾಗಿಲ್ಲ.
ಉದಾಹರಣೆಗೆ:
- Required field → Missing value check
- Date field → Valid date check
- ID → Duplicate check
- Numeric field → Range check
- Dataset → Volume check
- Pipeline → Freshness check
ಅಂದರೆ Dataಗೆ ಸಂಬಂಧಿಸಿದ expected behaviour ಅನ್ನು ಮೊದಲು define ಮಾಡಬೇಕು.
Step 4: Baseline ಅರ್ಥಮಾಡಿಕೊಳ್ಳಿ
Data ಸಾಮಾನ್ಯವಾಗಿ ಹೇಗೆ ಕಾಣುತ್ತದೆ ಎಂಬುದನ್ನು ತಿಳಿದುಕೊಳ್ಳುವುದು ಮುಖ್ಯ.
ಉದಾಹರಣೆಗೆ:
ಪ್ರತಿದಿನ 1 ಲಕ್ಷ records ಬರುತ್ತಿದ್ದರೆ ಅದು ಒಂದು baseline.
ಸಾಮಾನ್ಯವಾಗಿ 1–1.2 ಲಕ್ಷ records ಬರುತ್ತಿದ್ದಾಗ ಒಂದು ದಿನ 20,000 ಮಾತ್ರ ಬಂದರೆ ಅದು investigationಗೆ signal ಆಗಬಹುದು.
Step 5: Anomaly ಬಂದಾಗ Investigate ಮಾಡಿ
Alert ಬಂದ ತಕ್ಷಣ “Model problem” ಎಂದು assume ಮಾಡಬಾರದು.
ಮೊದಲು:
Data source → Pipeline → Transformation → Dataset → Model input
ಈ flowನಲ್ಲಿ ಎಲ್ಲಿ ಬದಲಾವಣೆ ಆಗಿದೆ ಎಂದು ಪರಿಶೀಲಿಸಬೇಕು.
Step 6: Root Cause Fix ಮಾಡಿ
Problem ಕಂಡುಬಂದ ನಂತರ source system, transformation logic, API ಅಥವಾ pipeline configurationನಲ್ಲಿ ಅಗತ್ಯವಾದ correction ಮಾಡಬಹುದು.
ನಂತರ corrected Data ಅನ್ನು validate ಮಾಡಿ AI system ಮತ್ತೆ expected ರೀತಿಯಲ್ಲಿ ಕೆಲಸ ಮಾಡುತ್ತಿದೆಯೇ ಎಂದು ಪರಿಶೀಲಿಸಬೇಕು.
→ AWS Glue — Evaluating Data Quality for ETL Jobs
Data Lineage ಯಾಕೆ ಮುಖ್ಯ?
AI Data Observability ಬಗ್ಗೆ ಮಾತನಾಡುವಾಗ Data Lineage concept ಕೂಡ ಬಹಳ ಮುಖ್ಯ.
Data Lineage ಎಂದರೆ Data ಎಲ್ಲಿಂದ ಬಂತು, ಯಾವ processing stages ಮೂಲಕ ಹೋಯಿತು ಮತ್ತು ಕೊನೆಯಲ್ಲಿ ಎಲ್ಲಿ ಬಳಸಲಾಯಿತು ಎಂಬ ಅದರ journey.
ಸರಳವಾಗಿ:
Source → Transformation → Dataset → Model Input → AI Application
ಇದು Dataನ ಒಂದು ರೀತಿಯ “travel history”.
ಒಂದು AI Modelಗೆ ತಪ್ಪಾದ Data ಹೋಗಿದೆ ಎಂದುಕೊಳ್ಳಿ.
Data Lineage ಇಲ್ಲದಿದ್ದರೆ:
“ಈ Data ಎಲ್ಲಿಂದ ಬಂತು?”
ಎಂಬ ಪ್ರಶ್ನೆಗೆ ಉತ್ತರ ಹುಡುಕಲು ಹೆಚ್ಚು ಸಮಯ ಬೇಕಾಗಬಹುದು.
Lineage ಇದ್ದರೆ Data ಯಾವ sourceನಿಂದ ಬಂದಿದೆ, ಯಾವ transformation ನಡೆದಿದೆ ಮತ್ತು ಯಾವ downstream systemಗೆ ಹೋಗಿದೆ ಎಂಬುದನ್ನು trace ಮಾಡಲು ಸುಲಭವಾಗಬಹುದು.
ಅದರ ಕಾರಣದಿಂದ Data Observability ಮತ್ತು Data Lineage ಒಟ್ಟಿಗೆ ಕೆಲಸ ಮಾಡಿದಾಗ troubleshooting ಇನ್ನಷ್ಟು structured ಆಗಬಹುದು.
AI Data Observability ಮತ್ತು AI Reliability ನಡುವಿನ ಸಂಬಂಧ
AI Reliability ಎಂದರೆ AI system expected ರೀತಿಯಲ್ಲಿ consistently ಕೆಲಸ ಮಾಡುವ ಸಾಮರ್ಥ್ಯ ಎಂದು ಸರಳವಾಗಿ ಅರ್ಥಮಾಡಿಕೊಳ್ಳಬಹುದು.
ಇದರಲ್ಲಿ Model ಮಾತ್ರವಲ್ಲ.
ಒಂದು AI applicationನಲ್ಲಿ:
Data → Infrastructure → Model → Application → User
ಎಲ್ಲವೂ ಒಂದಕ್ಕೊಂದು ಸಂಬಂಧ ಹೊಂದಿರಬಹುದು.
Data ತಪ್ಪಾಗಿದ್ದರೆ Model output ಮೇಲೆ ಪರಿಣಾಮ.
Model ಸರಿಯಾಗಿದ್ದರೂ infrastructure ಸಮಸ್ಯೆಯಿದ್ದರೆ applicationನಲ್ಲಿ ಸಮಸ್ಯೆ.
Application ಸರಿಯಾಗಿದ್ದರೂ input Data stale ಆಗಿದ್ದರೆ userಗೆ outdated result ಸಿಗಬಹುದು.
ಹೀಗಾಗಿ AI Reliability ಅನ್ನು ಕಾಪಾಡಲು Data health ಕೂಡ ಗಮನಿಸುವುದು ಮುಖ್ಯ.
ಇಲ್ಲಿ AI Data Observability ಒಂದು supporting layer ಆಗಿ ಕೆಲಸ ಮಾಡಬಹುದು.
→ Model Context Protocol (MCP) Explained: Complete Beginner Guide with AI Agent Examples (2026)
Small Businessಗೆ AI Data Observability ಬೇಕೇ?
ಎಲ್ಲಾ Small Businessesಗೂ enterprise-level Data Observability platform ಅಗತ್ಯವಿದೆ ಎಂದು ಹೇಳಲು ಸಾಧ್ಯವಿಲ್ಲ.
ಒಂದು ಸಣ್ಣ business ಕೇವಲ simple spreadsheet ಬಳಸುತ್ತಿದ್ದರೆ full-scale observability setup ಅಗತ್ಯವಿಲ್ಲದಿರಬಹುದು.
ಆದರೆ businessನಲ್ಲಿ AI usage ಹೆಚ್ಚಾದಂತೆ situation ಬದಲಾಗಬಹುದು.
ಉದಾಹರಣೆಗೆ:
- Customer Data Analysis
- AI Recommendation
- Automated Reporting
- AI Customer Support
- Sales Prediction
- Marketing Automation
- Document Processing
ಇಂತಹ workflows ಹೆಚ್ಚು Data ಮೇಲೆ depend ಆಗಿದ್ದರೆ basic Data Quality checks ಉಪಯುಕ್ತವಾಗಬಹುದು.
Small Businessನಲ್ಲಿ ಆರಂಭಕ್ಕೆ ದೊಡ್ಡ setup ಬದಲಾಗಿ:
Data Source → Important Checks → Alerts → Manual Investigation
ಎಂಬ simple workflow ಸಾಕಾಗಬಹುದು.
Business ಮತ್ತು Data volume ಬೆಳೆದಂತೆ observability capabilities ಅನ್ನು ಹಂತ ಹಂತವಾಗಿ ಹೆಚ್ಚಿಸಬಹುದು.
→ How to Create Your Own Personal AI Assistant Without Coding
AI Data Observabilityನ Limitations
AI Data Observability ಬಹಳ ಉಪಯುಕ್ತವಾಗಿದ್ದರೂ ಇದು magic solution ಅಲ್ಲ.
ಇದು Data problemಗಳನ್ನು automatically solve ಮಾಡುತ್ತದೆ ಎಂದು assume ಮಾಡಬಾರದು.
Observability Problem ಅನ್ನು Detect ಮಾಡಬಹುದು; Fix ಯಾವಾಗಲೂ ಮಾಡುವುದಿಲ್ಲ
ಒಂದು system Data volume ಕಡಿಮೆಯಾಗಿದೆ ಎಂದು alert ಕೊಡಬಹುದು.
ಆದರೆ volume ಯಾಕೆ ಕಡಿಮೆಯಾಯಿತು?
API ಸಮಸ್ಯೆಯೇ?
Source system ಸಮಸ್ಯೆಯೇ?
Authentication issueನಾ?
Transformation logic ಬದಲಾಗಿದೆಯೇ?
ಇದನ್ನು investigate ಮಾಡಬೇಕಾಗಬಹುದು.
False Alerts ಬರಬಹುದು
ಪ್ರತಿ unusual change ಕೂಡ real problem ಆಗಿರಬೇಕೆಂದಿಲ್ಲ.
ಕೆಲವೊಮ್ಮೆ business event ಕಾರಣದಿಂದ Data volume ನಿಜವಾಗಿಯೂ ಹೆಚ್ಚಾಗಬಹುದು.
ಉದಾಹರಣೆಗೆ festival sale ಸಮಯದಲ್ಲಿ customer activity ಸಾಮಾನ್ಯ ದಿನಗಳಿಗಿಂತ ಹೆಚ್ಚಾಗಬಹುದು.
ಆದ್ದರಿಂದ alert ಬಂದ ತಕ್ಷಣ panic ಮಾಡುವ ಬದಲು context ಅರ್ಥಮಾಡಿಕೊಳ್ಳಬೇಕು.
Data Observability Alone ಸಾಕಾಗುವುದಿಲ್ಲ
ಒಂದು reliable AI systemಗೆ Data Observability ಜೊತೆಗೆ:
- Model Monitoring
- Application Monitoring
- Infrastructure Monitoring
- Security
- Access Control
- Data Governance
ಇವುಗಳೂ ಅಗತ್ಯವಾಗಬಹುದು.
ಅಂದರೆ AI system reliability ಒಂದು single toolನಿಂದ ಸಿಗುವುದಿಲ್ಲ.
AI Data Observabilityನ Future
AI systems ಹೆಚ್ಚು complex ಆಗುತ್ತಿದ್ದಂತೆ Data flows ಕೂಡ ಹೆಚ್ಚು complex ಆಗುತ್ತಿವೆ.
ಒಂದು modern AI applicationನಲ್ಲಿ ಒಂದೇ Data source ಇರುವ ಬದಲು ಹಲವು:
APIs + Databases + Cloud Storage + User Data + External Data + Real-time Streams
ಇರಬಹುದು.
ಅದರ ಜೊತೆಗೆ AI Agents, RAG systems ಮತ್ತು automated workflows ಹೆಚ್ಚಾದಂತೆ Data ಹಲವು stagesನಲ್ಲಿ process ಆಗಬಹುದು.
ಇಂತಹ environmentನಲ್ಲಿ ಕೇವಲ “pipeline running” ಎನ್ನುವುದು ಸಾಕಾಗುವುದಿಲ್ಲ.
Pipelineನಲ್ಲಿ ಹೋಗುತ್ತಿರುವ Data expected ರೀತಿಯಲ್ಲಿ ಇದೆಯೇ?
ಎಂಬ ಪ್ರಶ್ನೆಯೂ ಮುಖ್ಯವಾಗುತ್ತದೆ.
ಮುಂದೆ AI systemsನಲ್ಲಿ Data Quality, Lineage, Monitoring ಮತ್ತು Observability ಪರಸ್ಪರ ಇನ್ನಷ್ಟು closely connected ಆಗುವ ಸಾಧ್ಯತೆ ಇದೆ.
ಆದರೆ ಇಲ್ಲಿ ಒಂದು ಮುಖ್ಯ point ನೆನಪಿರಲಿ:
ಹೆಚ್ಚು observability ಎಂದರೆ automatically better AI ಎಂದಲ್ಲ.
Observability ಸಮಸ್ಯೆಯನ್ನು ಬೇಗ ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ಮತ್ತು investigate ಮಾಡಲು ಸಹಾಯ ಮಾಡಬಹುದು. Final reliabilityಗೆ architecture, Data quality, Model quality, testing ಮತ್ತು human oversight ಕೂಡ ಮುಖ್ಯ.
Key Takeaways
- AI Data Observability ಎಂದರೆ AI systemsನಲ್ಲಿ Dataನ health, quality, freshness ಮತ್ತು changes ಬಗ್ಗೆ continuous visibility ಹೊಂದುವ approach.
- Data ಸರಿಯಾಗಿಲ್ಲದಿದ್ದರೆ ಉತ್ತಮ AI Model ಕೂಡ unreliable output ನೀಡುವ ಸಾಧ್ಯತೆ ಇದೆ.
- Missing Data, duplicate Data, stale Data, schema changes ಮತ್ತು unusual Data volume ಪ್ರಮುಖ ಸಮಸ್ಯೆಗಳಾಗಬಹುದು.
- Data Monitoring ಒಂದು metric ಅಥವಾ condition ಮೇಲೆ ಗಮನಹರಿಸಬಹುದು; Observability ಸಮಸ್ಯೆಯ context ಮತ್ತು investigationಗೆ ಹೆಚ್ಚಿನ visibility ನೀಡುವ broader approach ಆಗಿರಬಹುದು.
- Data Lineage Data ಎಲ್ಲಿಂದ ಬಂತು ಮತ್ತು ಯಾವ stages ಮೂಲಕ ಹೋಯಿತು ಎಂಬುದನ್ನು trace ಮಾಡಲು ಸಹಾಯ ಮಾಡುತ್ತದೆ.
- Data Observability ಮತ್ತು Model Monitoring ಎರಡೂ ವಿಭಿನ್ನವಾದರೂ ಪರಸ್ಪರ complementary ಆಗಿರಬಹುದು.
- Observability problem detect ಮಾಡಲು ಸಹಾಯ ಮಾಡುತ್ತದೆ; ಪ್ರತಿಯೊಂದು problem ಅನ್ನು ಅದು ತಾನೇ solve ಮಾಡುವುದಿಲ್ಲ.
- Small Businessಗಳು ತಮ್ಮ Data volume ಮತ್ತು AI complexityಗೆ ಅನುಗುಣವಾಗಿ basic checksನಿಂದ ಆರಂಭಿಸಬಹುದು.
In This Article You Learned
ಈ articleನಲ್ಲಿ ನಾವು AI Data Observability ಬಗ್ಗೆ basic conceptನಿಂದ practical workflowವರೆಗೆ ನೋಡಿದೆವು.
ಮೊದಲು AI systemನಲ್ಲಿ Data ಯಾಕೆ ಅಷ್ಟು ಮುಖ್ಯ ಎಂದು ಅರ್ಥಮಾಡಿಕೊಂಡೆವು. ನಂತರ Data Quality, Data Monitoring ಮತ್ತು Data Observability ನಡುವಿನ ವ್ಯತ್ಯಾಸವನ್ನು ನೋಡಿದೆವು.
ಅದರ ನಂತರ Data Freshness, Completeness, Consistency, Validity ಮತ್ತು Volume ಮುಂತಾದ ವಿಷಯಗಳನ್ನು observe ಮಾಡುವುದು ಹೇಗೆ ಎಂಬುದನ್ನು ನೋಡಿದೆವು.
ಮುಂದೆ Data ಸಮಸ್ಯೆಗಳು AI Model ಮತ್ತು final output ಮೇಲೆ ಹೇಗೆ ಪರಿಣಾಮ ಬೀರಬಹುದು, Data Lineage ಯಾಕೆ ಮುಖ್ಯ ಮತ್ತು Small Businessಗಳು ಇದನ್ನು ಹೇಗೆ simple ಆಗಿ ಆರಂಭಿಸಬಹುದು ಎಂಬುದನ್ನೂ ತಿಳಿದುಕೊಂಡೆವು.
ಕೊನೆಯಲ್ಲಿ ಒಂದು ಮುಖ್ಯ lesson ಇದೆ:
AI systemನ reliability ಕೇವಲ Modelನ strength ಮೇಲೆ depend ಆಗುವುದಿಲ್ಲ; Modelಗೆ ಹೋಗುವ Data ಕೂಡ trustworthy ಆಗಿರಬೇಕು.
Final Article Summary
ಸರಳವಾಗಿ ಹೇಳುವುದಾದರೆ, AI Data Observability ಎಂದರೆ AI system ಬಳಸುವ Data ಬಗ್ಗೆ “ಏನು ನಡೆಯುತ್ತಿದೆ?” ಎಂಬುದನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ಸಹಾಯ ಮಾಡುವ visibility layer.
Data ಎಲ್ಲಿಂದ ಬರುತ್ತಿದೆ, ಎಷ್ಟು ಬರುತ್ತಿದೆ, ಸಮಯಕ್ಕೆ ಬರುತ್ತಿದೆಯೇ, expected formatನಲ್ಲಿ ಇದೆಯೇ, ಯಾವುದಾದರೂ unusual change ಆಗಿದೆಯೇ ಎಂಬುದನ್ನು ಗಮನಿಸುವ ಮೂಲಕ AI systemsನಲ್ಲಿ Data-related problems ಅನ್ನು ಬೇಗ identify ಮಾಡಲು ಸಾಧ್ಯವಾಗಬಹುದು.
ಒಂದು AI Model ಅನ್ನು ಉತ್ತಮವಾಗಿ train ಮಾಡುವುದು ಮುಖ್ಯ. ಆದರೆ productionನಲ್ಲಿ ಆ Modelಗೆ ಪ್ರತಿದಿನ ಬದಲಾಗುವ Data ಬರುತ್ತಿದ್ದರೆ, ಆ Dataನ health ಕೂಡ ಗಮನಿಸಬೇಕಾಗುತ್ತದೆ.
ಅದಕ್ಕಾಗಿಯೇ modern AI infrastructureನಲ್ಲಿ Data Quality + Data Monitoring + Data Lineage + Data Observability ಎಂಬ concepts ಹೆಚ್ಚು practical importance ಪಡೆಯುತ್ತಿವೆ.
Conclusion
AI ಬಗ್ಗೆ ಮಾತನಾಡುವಾಗ ನಾವು ಸಾಮಾನ್ಯವಾಗಿ Model, Chatbot, AI Agent ಅಥವಾ GPU ಬಗ್ಗೆ ಹೆಚ್ಚು ಗಮನ ಕೊಡುತ್ತೇವೆ. ಆದರೆ AI systemನ ಹಿಂದೆ ಕೆಲಸ ಮಾಡುವ Data pipeline ಕೂಡ ಅಷ್ಟೇ ಮುಖ್ಯ.
ಒಂದು pipeline quietly wrong Data ಕಳುಹಿಸುತ್ತಿದ್ದರೆ, Model error ಕೊಡದೇ ಇದ್ದರೂ final outputನಲ್ಲಿ ಸಮಸ್ಯೆ ಕಾಣಿಸಿಕೊಳ್ಳಬಹುದು.
ಇದನ್ನು ಗಮನಿಸಲು AI Data Observability ಒಂದು useful approach.
ಇದರ ಉದ್ದೇಶ ಪ್ರತಿಯೊಂದು Data point ಅನ್ನು manually check ಮಾಡುವುದು ಅಲ್ಲ. ಬದಲಾಗಿ systemನಲ್ಲಿ ಸಾಮಾನ್ಯವಾಗಿ ಏನು ನಡೆಯುತ್ತಿದೆ ಎಂಬುದನ್ನು ಅರ್ಥಮಾಡಿಕೊಂಡು, unexpected changes ಬಂದಾಗ ಅವುಗಳನ್ನು ಬೇಗ identify ಮತ್ತು investigate ಮಾಡಲು ಬೇಕಾದ visibility ನೀಡುವುದು.
ಮುಂದಿನ ಹಂತದಲ್ಲಿ AI systems ಇನ್ನಷ್ಟು complex ಆಗುತ್ತಿದ್ದಂತೆ Data quality ಮತ್ತು AI reliability ನಡುವಿನ ಸಂಬಂಧವನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳುವುದು developers ಮಾತ್ರವಲ್ಲ, AI ಬಳಸುವ businessesಗೂ ಮುಖ್ಯವಾಗಲಿದೆ.
ಅಂತಿಮವಾಗಿ ಒಂದು ಸರಳ formula ನೆನಪಿಟ್ಟುಕೊಳ್ಳಬಹುದು:
Good Model + Poor Data = Unreliable AI
ಆದ್ದರಿಂದ trustworthy AI system ನಿರ್ಮಿಸಲು Model ಜೊತೆಗೆ Data ಕೂಡ ಗಮನಿಸಬೇಕು.
FAQs
AI Data Observability ಎಂದರೇನು?
AI Data Observability ಎಂದರೆ AI system ಬಳಸುವ Dataನ quality, freshness, completeness, consistency ಮತ್ತು unexpected changes ಬಗ್ಗೆ continuous visibility ಹೊಂದುವ ವಿಧಾನ.
AI Data Observability ಯಾಕೆ ಬೇಕು?
AI Modelಗೆ ಹೋಗುವ Dataನಲ್ಲಿ ಸಮಸ್ಯೆ ಇದ್ದರೆ final output ಮೇಲೆ ಪರಿಣಾಮ ಬೀರಬಹುದು. Data ಸಮಸ್ಯೆಗಳನ್ನು ಬೇಗ identify ಮತ್ತು investigate ಮಾಡಲು Observability ಸಹಾಯ ಮಾಡಬಹುದು.
Data Monitoring ಮತ್ತು Data Observability ಒಂದೇನಾ?
ಎರಡೂ related concepts. Data Monitoring ಸಾಮಾನ್ಯವಾಗಿ ನಿರ್ದಿಷ್ಟ metrics ಅಥವಾ conditions ಅನ್ನು track ಮಾಡುತ್ತದೆ. Data Observability ಹೆಚ್ಚು broad visibility ಮತ್ತು ಸಮಸ್ಯೆಯ context ಅನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ಸಹಾಯ ಮಾಡುವ approach ಆಗಿದೆ.
AI Data Observability Model Monitoringಗೆ alternativeನಾ?
ಇಲ್ಲ. ಎರಡೂ ವಿಭಿನ್ನ ವಿಷಯಗಳನ್ನು ಗಮನಿಸುತ್ತವೆ. Data Observability Data health ಮತ್ತು pipeline-related issues ಮೇಲೆ focus ಮಾಡುತ್ತದೆ. Model Monitoring Model performance ಮತ್ತು model-related behaviour ಮೇಲೆ focus ಮಾಡುತ್ತದೆ.
Data Lineage ಎಂದರೇನು?
Data Lineage ಎಂದರೆ Data ಯಾವ sourceನಿಂದ ಬಂದಿದೆ, ಯಾವ processing ಅಥವಾ transformation stages ಮೂಲಕ ಹೋಯಿತು ಮತ್ತು ಕೊನೆಯಲ್ಲಿ ಎಲ್ಲಿ ಬಳಸಲಾಗಿದೆ ಎಂಬುದನ್ನು trace ಮಾಡುವ ಮಾಹಿತಿ.
Small Businessಗೆ AI Data Observability ಬೇಕೇ?
Businessನ Data volume ಮತ್ತು AI usage ಮೇಲೆ depend ಆಗುತ್ತದೆ. Simple workflowsಗೆ basic Data Quality checks ಸಾಕಾಗಬಹುದು. AI workflows ಮತ್ತು Data pipelines ಹೆಚ್ಚಾದಂತೆ Observability ಹೆಚ್ಚು ಉಪಯುಕ್ತವಾಗಬಹುದು.
AI Data Observability Data problems ಅನ್ನು automatically fix ಮಾಡುತ್ತದೆಯೇ?
ಅಗತ್ಯವಿಲ್ಲ. ಇದು problem ಅಥವಾ anomaly ಅನ್ನು identify ಮಾಡಲು ಮತ್ತು investigate ಮಾಡಲು ಸಹಾಯ ಮಾಡಬಹುದು. Root cause fix ಮಾಡಲು engineering ಅಥವಾ operations intervention ಬೇಕಾಗಬಹುದು.
Continue Learning
AI systems ಬಗ್ಗೆ ಇನ್ನಷ್ಟು ಅರ್ಥಮಾಡಿಕೊಳ್ಳಲು ಮುಂದಿನ ಹಂತದಲ್ಲಿ AI Agents, Model Monitoring, Data Quality, RAG, AI Infrastructure ಮತ್ತು AI Reliability ಮುಂತಾದ concepts ಕಲಿಯುವುದು ಉಪಯುಕ್ತ.
ವಿಶೇಷವಾಗಿ AI Agent ಅಥವಾ RAG system ನಿರ್ಮಿಸುವಾಗ Data ಎಲ್ಲಿಂದ ಬರುತ್ತದೆ, ಹೇಗೆ process ಆಗುತ್ತದೆ ಮತ್ತು final responseಗೆ ಹೇಗೆ ಬಳಸಲಾಗುತ್ತದೆ ಎಂಬ flow ಅರ್ಥಮಾಡಿಕೊಳ್ಳುವುದು ಬಹಳ ಮುಖ್ಯ.
AI ಅನ್ನು ಕೇವಲ Chatbot ಆಗಿ ನೋಡುವುದಕ್ಕಿಂತ Model + Data + Infrastructure + Workflow ಎಂಬ complete system ಆಗಿ ಅರ್ಥಮಾಡಿಕೊಂಡಾಗ AI technology ಬಗ್ಗೆ ಇನ್ನಷ್ಟು clear picture ಸಿಗುತ್ತದೆ.
Final CTA
AI technology ಬಗ್ಗೆ ಕನ್ನಡದಲ್ಲಿ simple ಆಗಿ, practical ಆಗಿ ಮತ್ತು unnecessary technical complexity ಇಲ್ಲದೆ ಕಲಿಯಲು AI Kannada Techನ ಮುಂದಿನ articles ಓದಿ.
AI Models, AI Agents, AI Tools, Data, Automation ಮತ್ತು ಹೊಸ AI technologies ಬಗ್ಗೆ beginner-friendly Kannada-English hybrid explanationsಗಾಗಿ AI Kannada Tech ಜೊತೆ continue learning ಮಾಡಿ.